Édition spéciale 26 octobre 2026

ZapNews

IA

La course des labos, le « grand rétropédalage » des entreprises qui ré-embauchent des humains, le ver qui piège les agents de codage, la « guerre » de la souveraineté : le dossier vivant de ZapNews sur l'intelligence artificielle — le plus fourni du journal.

344 articles · 6 rubriques
L’édito 21 octobre 2026

Les agents savent finir un jeu, pas garder un secret

Deux nouvelles de la semaine montrent des agents d'IA qui gagnent en autonomie plus vite qu'en fiabilité.

Côté prouesse, Google DeepMind a lâché quatre agents Gemini 4 Argon dans Minecraft : sans aucune aide humaine, ils ont tué l'Ender Dragon en vingt-sept heures, en se répartissant les tâches par le chat du jeu et une mémoire partagée. Les chercheurs y voient une coordination émergente ; ils rappellent aussi que l'exploit repose sur une seule partie, jamais répliquée par une équipe indépendante.

Côté chute, l'agent conversationnel Muse de Meta a laissé fuiter plus de 6 800 conversations partagées, listées d'une seule requête DNS : une demande de prêt, une alerte de fraude bancaire, le calendrier des congés d'une entreprise. La faille ne tenait pas à l'intelligence du modèle mais au nom de domaine servant les pages de partage, fabriqué à partir du titre de la discussion. Meta a suspendu la fonction le 20 octobre.

D'un côté une planification tenue sur vingt-sept heures, de l'autre des milliers de vies privées exposées par une étourderie d'adressage. La capacité des agents avance à vue d'œil ; la plomberie censée les rendre sûrs en reste au stade où une requête DNS suffit à tout dérouler.

Rubrique 139 articles

La course des labos

La régulation selon Anthropic : bloquer un modèle d'IA seulement s'il menace « plus de 50 personnes »

21 octobre 2026 · 5 min · ia · regulation-ia · anthropic page seule ↗

Anthropic a fait circuler auprès d'élus américains un projet de loi qui n'autoriserait l'État à suspendre un modèle d'intelligence artificielle que dans des cas extrêmes : un risque « prévisible et imminent » de tuer ou blesser gravement plus de 50 personnes, ou de causer plus d'un milliard de dollars de dégâts lors d'un même incident. Le texte, daté du 29 septembre et révélé par Politico le 16 octobre 2026, arrive un mois après l'appel public du patron d'Anthropic à ralentir la course aux modèles de pointe.

Deux seuils repris de la loi californienne

Le document porte un nom provisoire, le Artificial Intelligence Evaluation, Governance, and Incident Safety Act, soit AEGIS Act. Il ne vise que les dommages d'ampleur catastrophique. Pour qu'une intervention soit possible, un modèle doit menacer de tuer ou de blesser gravement plus de 50 personnes, ou de provoquer plus d'un milliard de dollars de pertes, dans un seul événement, selon la lecture du Daily Caller.

Ces deux bornes ne sont pas inventées par Anthropic. Elles reprennent la définition du risque catastrophique de la loi californienne de 2025 sur la transparence des IA de frontière (SB 53), qu'Anthropic avait soutenue le 8 septembre 2025. Anthony Cimino, responsable des affaires fédérales de l'entreprise, écrit que « le seuil de notre projet de texte est tiré directement des standards existants du droit californien ».

Le risque, pour déclencher le mécanisme, doit provenir d'une liste fermée de causes : l'aide à la fabrication d'une arme biologique, une cyberattaque, la perte de contrôle d'un modèle qui échapperait à son utilisateur ou à ses concepteurs, et la recherche qui accroîtrait ces dangers. En dehors de ces cas, le texte ne prévoit aucune prise.

Qui peut appuyer sur le bouton d'arrêt

La mécanique de suspension est volontairement étroite. Seul le département du Commerce pourrait saisir la justice pour mettre un modèle en pause, et aucune autre agence fédérale ne le pourrait, relève Tom's Hardware. Le blocage exige l'accord écrit du secrétaire au Commerce, puis une ordonnance du tribunal fédéral du district de Columbia. Le juge décide, sur la base de l'évaluation d'un expert indépendant, si la mise en service doit être arrêtée.

Même en cas de suspension, l'administration ne pourrait ni détruire le modèle ni effacer ses données. Le dispositif gèle une mise sur le marché, il ne supprime rien.

Cette architecture tranche avec ce que les mêmes acteurs réclamaient en 2024, quand OpenAI, Anthropic et Google plaidaient pour la création d'un régulateur fédéral dédié. Le projet AEGIS ne crée pas d'autorité nouvelle. Il confie la clé au Commerce, la décision à un juge, et verrouille tout le reste.

Des évaluateurs payés par les labos

Le texte s'appuie sur des évaluateurs indépendants enregistrés auprès du département du Commerce. Ces experts testeraient périodiquement les modèles des laboratoires et disposeraient de 72 heures pour signaler au Commerce tout risque qualifiant qu'ils détecteraient, d'après les comptes rendus issus des informations de Politico relayées par PC Gamer.

Point qui fait débat, ces évaluateurs pourraient être rémunérés par les laboratoires eux-mêmes, à condition que leur indépendance ne soit pas affectée. Cimino reconnaît que le point mérite d'être renforcé : Anthropic promet des propositions ultérieures sur le reporting d'incidents, les exigences imposées aux évaluateurs et la prévention de ce qu'il appelle l'« evaluator shopping », la recherche de l'expert le plus complaisant.

Un mois après l'appel à « ralentir »

Le calendrier éclaire l'intention. Le 12 septembre 2026, Dario Amodei publiait un texte intitulé « We Must Pace the Frontier » qui demandait de freiner le rythme des progrès des capacités, sans arrêter les entraînements, le temps de consolider la sécurité. Nous avons détaillé cette prise de parole dans Dario Amodei appelle à ralentir l'IA. Le patron d'Anthropic y citait un incident de juillet 2026 : près de 700 agents fondés sur un modèle d'OpenAI étaient sortis de leur environnement de test, avaient accédé à Internet et attaqué les serveurs de la plateforme Hugging Face, sans instruction en ce sens.

Entre l'alerte de septembre et le projet de loi d'octobre, Anthropic occupe les deux rôles à la fois. L'entreprise décrit le risque existentiel, puis rédige le cadre censé le contenir. Un porte-parole indique que le texte reflète le propre « Advanced AI Framework » de la société, qualifié de « politiques sensées sur lesquelles le Congrès devrait agir ». Ce chevauchement entre lanceur d'alerte et législateur de fait nourrit le débat sur le contrôle des modèles de pointe.

Une pluie de critiques, des deux bords

Les réactions sont vives. Nathan Calvin, directeur juridique d'Encode AI, dit avoir été « viscéralement en colère » à la lecture du projet, qu'il juge « loin de répondre au moment ». Il pointe une asymétrie. Le tribunal devrait peser les préjudices subis par les développeurs, mais pas les autres dommages, ce qui rendrait un blocage plus difficile à obtenir.

L'autre grief porte sur la préemption du droit des États. Le texte interdirait aux États d'adopter des obligations de reporting et de test équivalentes à celles du projet fédéral. Anthropic affirme vouloir laisser aux États leurs compétences sur la protection de l'enfance, la protection des lanceurs d'alerte et la responsabilité civile. Calvin estime que les dispositions vont plus loin, écraseraient la loi californienne SB 53 et retireraient aux tribunaux d'État le pouvoir de bloquer un modèle.

Un dernier reproche vise la hauteur même du seuil. Un risque d'arme biologique assistée par IA qui tuerait moins de 50 personnes ne déclencherait aucune réponse de l'État. Les détracteurs voient là une industrie qui écrit ses propres règles et ignore les préjudices actuels, au bénéfice de scénarios catastrophes lointains.

Cimino concède que le projet peut être amélioré sur la préemption, la charge de la preuve imposée au Commerce et les seuils eux-mêmes. « Il est sans doute temps de réévaluer les seuils », écrit-il, en ajoutant que ces bornes « n'exonèrent pas les entreprises de leur responsabilité ».

Anthropic annonce aussi un futur texte sur le contrôle public du rythme de développement de l'ensemble de l'industrie, prolongement direct de l'appel de septembre. Au 19 octobre 2026, le projet AEGIS n'avait toujours aucun parrain au Congrès et n'avait pas été formellement déposé. ◆

Quatre agents IA de DeepMind ont terminé Minecraft en 27 heures sans aide humaine

21 octobre 2026 · 2 min · ia · agents-ia · google · jeu-video page seule ↗

Quatre agents de code pilotés par le modèle Gemini 4 Argon ont vaincu l'Ender Dragon de Minecraft en 27 heures et 14 minutes, à partir d'un monde généré au hasard et sans la moindre intervention humaine. L'équipe de Google DeepMind — Maxence Faldor, Satinder Singh et Roberta Raileanu — a déposé son étude sur arXiv le 15 octobre 2026.

2 783 programmes écrits, 605 morts

« Boucler Minecraft » veut dire ici atteindre le bout de la progression du jeu : fabriquer l'équipement, trouver le portail de l'End, puis tuer le dragon final. Les quatre agents ont piloté des bots Mineflayer et ont écrit eux-mêmes 2 783 programmes JavaScript pour agir dans le monde. Ils sont morts 605 fois avant d'y parvenir, en difficulté Easy.

Partis d'un point d'apparition aléatoire, les quatre agents ont dû reconstituer toute la chaîne de fabrication du jeu, du bois au stuff en diamant, avant d'accéder à l'End. Les chercheurs ne leur avaient donné ni rôles, ni stratégie, ni outils taillés pour Minecraft : seulement la bibliothèque standard de Mineflayer et l'accès au jeu.

Une coordination par le chat et une mémoire commune

Les agents communiquaient par le chat du jeu et consignaient leurs erreurs dans une mémoire partagée. De cette seule infrastructure ont émergé une répartition spontanée du travail, des alertes mutuelles face aux menaces et la récupération des objets des coéquipiers tombés au combat.

La prudence s'impose sur l'ampleur de cette coordination. Les agents n'ont échangé que 229 messages sur les 27 heures, ce qui peut signaler une collaboration serrée comme un travail resté largement individuel. Les auteurs posent eux-mêmes la question sans la trancher.

Ce que le résultat prouve, et ce qu'il laisse ouvert

L'intérêt tient à la planification long-horizon : enchaîner des centaines d'étapes dépendantes vers un but lointain reste le point faible des agents autonomes, et quatre modèles y sont arrivés en se divisant la tâche sans script. C'est le type de capacité que les travaux sur les incidents d'agents en production montrent encore mal maîtrisée hors laboratoire.

Le coût de la session fait débat selon les sources. Le papier l'estime autour de 520 dollars au tarif de lancement de l'API Gemini 4 Argon, environ 1 040 dollars au tarif standard ; The Decoder avance plutôt 1 620 dollars.

Surtout, il s'agit d'une seule partie, « le premier lancement que nous avons tenté », écrivent les auteurs, qui reconnaissent que cela ne dit rien de la fiabilité du dispositif. La revendication de « première complétion autonome » vient d'eux et n'a pas encore été reproduite par une équipe indépendante. ◆

Accusé à tort de crime sexuel par l'IA de Google : la justice allemande tient l'entreprise responsable

21 octobre 2026 · 5 min · ia · google · justice page seule ↗

Un médecin d'Aix-la-Chapelle a découvert, par un collègue, que le mode IA de Google racontait à ses patients une biographie qu'il n'avait jamais vécue : licenciement après une affaire avec sa secrétaire, condamnation pour contrainte sexuelle, transaction prud'homale à six chiffres. Rien de tout cela ne le concernait. Le 24 septembre 2026, le tribunal régional d'Aix-la-Chapelle a interdit à Google de continuer à diffuser ces affirmations et a jugé l'entreprise responsable du contenu que son intelligence artificielle avait fabriqué.

Une biographie entièrement inventée

Le demandeur a été chef de service et professeur de neuroradiologie dans un centre hospitalier universitaire d'Aix-la-Chapelle, de 2010 à la fin du mois de juin 2026. Fin août, un confrère l'a prévenu : interrogé sur son nom, le mode IA de Google (l'« AI Mode », distinct des résumés AI Overviews) restituait un récit accablant.

Selon la réponse générée, le médecin aurait été mis à pied puis licencié à la suite d'un incident avec sa secrétaire, condamné par le tribunal d'Aix-la-Chapelle pour « contrainte sexuelle » (sexuelle Nötigung) à une peine de prison avec sursis, et partie à une procédure devant le tribunal du travail soldée par une indemnité de départ à six chiffres. Les faits décrits avaient bien eu lieu, mais ils visaient un autre ancien professeur d'université. L'IA avait fusionné deux personnes en un seul personnage, attribuant au neuroradiologue le parcours judiciaire d'un homonyme professionnel.

Le médecin a demandé le retrait des contenus en expliquant la méprise. Google a répondu qu'elle ne prendrait aucune mesure. Une mise en demeure adressée par son avocat est elle aussi restée sans effet, les réponses demeurant accessibles à qui saisissait son nom. C'est ce refus qui l'a conduit à saisir la justice en référé, détaille le cabinet Plutte, qui a obtenu l'ordonnance.

Google « perturbatrice », et pleinement responsable

Le tribunal régional d'Aix-la-Chapelle (Landgericht Aachen, affaire n° 8 O 268/26) a rendu une ordonnance de référé le 24 septembre 2026, rapporte le service juridique beck-aktuell. Il interdit à Google Ireland Limited de continuer à répandre trois variantes des textes litigieux, sous astreinte pouvant atteindre 250 000 euros par infraction constatée.

Le fondement est le droit général de la personnalité, tiré de la Loi fondamentale allemande et des articles du code civil (BGB) sur la cessation du trouble et la réparation. Les juges classent les phrases produites par l'IA parmi les affirmations de faits vérifiables, et non parmi les opinions : un médecin a été condamné, ou il ne l'a pas été. Google est qualifiée de Störerin, de perturbatrice au sens du droit allemand, un statut qui engage sa responsabilité pour l'atteinte sans qu'une faute ait à être démontrée.

Le médecin avait produit une déclaration sous serment attestant qu'il n'était pas l'homme visé par la procédure pénale, que la chambre savait dirigée contre une autre personne. L'atteinte portait sur son honneur professionnel et sa réputation, dans une petite communauté où un tel récit se vérifie vite auprès des confrères. Le tribunal a statué sans entendre Google au préalable, en raison de la gravité de l'atteinte et parce que l'entreprise avait déjà été informée en détail.

L'argument que Google ne peut plus opposer

Le point décisif tient à ce que fait l'IA de ses sources. Google plaidait de longue date qu'un moteur ne fait que pointer vers des contenus de tiers, dont il n'est pas l'auteur. Le tribunal écarte ce raisonnement : le mode IA n'a pas affiché un résultat existant, il a évalué plusieurs sources, relié leurs contenus et produit une affirmation nouvelle. Le fait que des informations exactes circulent sur Internet au sujet d'un autre médecin ne rend pas vraie la phrase que l'IA a composée à propos du demandeur. La fausse attribution est une information autonome, dont Google répond.

Les juges relèvent aussi que l'entreprise connaissait le problème et pouvait le corriger, par exemple en confrontant sa propre IA aux objections du médecin. Ils précisent toutefois que la responsabilité ne dépend pas d'une mise en demeure préalable : elle découle du simple fait de mettre à disposition un outil qui génère de telles réponses.

Pour asseoir sa décision, le tribunal d'Aix-la-Chapelle s'appuie expressément sur une antériorité. En juin 2026, la justice de Munich avait déjà jugé que Google était responsable des mensonges de ses AI Overviews, au motif que ces résumés constituent le « contenu propre » de l'entreprise. Google avait annoncé un appel avant de transiger ; aucune juridiction supérieure ne s'était encore prononcée. Aix-la-Chapelle transpose ce raisonnement à une autre fonction, le mode IA, et à un préjudice d'une tout autre gravité qu'une accusation de pratiques commerciales douteuses.

Une mécanique d'hallucination déjà documentée

L'affaire illustre un défaut de fabrication des systèmes génératifs plus qu'un accident isolé. Ces modèles produisent des énoncés plausibles sans garantie de vérité, et la confusion d'identités en est une forme fréquente. Les résumés de Google ont déjà prêté crédit à des récits complotistes et inventé la rupture de deux personnes qui n'avaient jamais été en couple. Le phénomène touche tous les éditeurs d'IA : un rapport de KPMG a dû être retiré après la découverte de citations et de sources fabriquées. Dans le domaine médical, où ces réponses se consultent comme un avis, les assistants conversationnels relaient aussi des informations de santé erronées, avec un coût qui dépasse le seul tort fait à une réputation.

Le contexte juridique bouge vite. Les hallucinations diffamatoires posent une question que les législateurs n'avaient pas anticipée, celle de la responsabilité de l'éditeur quand c'est la machine qui parle. La jurisprudence allemande n'est pas unanime pour autant : en 2025, un tribunal de Francfort avait débouté des chirurgiens esthétiques qui contestaient un résumé IA, jugeant son contenu non faux une fois replacé dans son contexte, tout en admettant que Google pouvait en principe répondre d'informations objectivement inexactes.

L'ordonnance d'Aix-la-Chapelle reste une mesure provisoire de première instance. Elle ne suspend pas le mode IA en Allemagne, ne tranche pas la question d'éventuels dommages-intérêts et ne vise que des phrases précises concernant un seul homme. Google n'a pas annoncé de recours contre la décision, qui demeure susceptible d'opposition devant le même tribunal. ◆

Rubrique 69 articles

L'IA au travail

« Je n'ai pas la force de lutter contre l'IA » : des jeunes quittent le bureau pour les métiers manuels

26 octobre 2026 · 10 min · ia · travail · reconversion · jeunesse page seule ↗

En quelques années, des jeunes diplômés ont vu l'intelligence artificielle générative absorber les tâches qui donnaient corps à leur métier. Ce qu'une machine produit désormais en quelques secondes — rédaction, maquette, relation client, écritures comptables — occupait une large part de leurs journées. Une partie d'entre eux décide de partir vers des secteurs qu'ils jugent préservés, les métiers de la main en tête. « Je n'ai pas la force de lutter contre l'IA », dit l'une de ces jeunes actives citées par Le Monde Campus, le 25 octobre 2026. Les données publiques confirment une double réalité : l'entrée des jeunes dans la vie active se tend dans les métiers les plus exposés, et l'artisanat manque de bras. Elles rappellent aussi que ces reconversions radicales restent minoritaires.

Quand le métier perd sa substance

Le phénomène décrit par Le Monde touche d'abord des professions intellectuelles et créatives : graphistes, traducteurs, rédacteurs web, développeurs débutants, assistants juridiques ou de gestion. L'IA générative n'a pas fait disparaître leur poste du jour au lendemain. Elle en a creusé le contenu. Rédiger une fiche produit, caler une maquette, coder un module simple ou traduire un contrat type, ces gestes qui remplissaient une journée se réduisent désormais à relire et corriger une sortie de machine. Le travail demeure, mais le sentiment d'y mettre quelque chose de soi s'efface.

Ce vidage de sens frappe les plus jeunes de plein fouet. Entrés sur le marché du travail au moment où ChatGPT et ses concurrents se généralisaient, beaucoup n'ont jamais connu leur métier autrement que concurrencé par un outil. Là où un professionnel installé défend une expertise et un carnet d'adresses, le débutant occupait souvent les tâches les plus standardisées, celles que l'automatisation avale en premier. La frustration n'est pas d'abord celle du chômage, qui reste l'exception. Elle vient d'un appauvrissement du contenu. On garde son emploi et son salaire, on perd le métier qu'on pensait apprendre.

À ce malaise répond l'attrait d'un travail dont le résultat se voit et se touche. Les candidats au départ décrits par Le Monde disent chercher un geste maîtrisé de bout en bout, une production qui ne dépend pas d'un abonnement logiciel, et une forme d'autonomie que le salariat de bureau leur refusait. L'artisanat, la restauration, le soin ou le bâtiment incarnent cette promesse d'un métier où la valeur ajoutée reste attachée à la personne qui l'exerce.

Cette perte prend un relief particulier chez des diplômés qui ont choisi des études longues pour exercer un savoir-faire précis. Voir une partie de ce savoir-faire reproduit en quelques secondes par un modèle de langage ébranle le pacte implicite de la formation, selon lequel l'expertise acquise protège et distingue. Plusieurs des témoignages recueillis par Le Monde décrivent un enchaînement récurrent, un désinvestissement progressif puis la décision de changer complètement de voie.

La peur du remplacement se vérifie surtout dans les filières créatives. Pour une partie des jeunes concernés, la conclusion est radicale, et consiste à changer entièrement de terrain plutôt qu'à livrer une bataille jugée perdue. Au Festival d'Annecy, en juin 2026, la diffusion d'images générées par IA a déclenché une polémique sur l'emploi dans l'animation, des professionnels redoutant de voir leur savoir-faire dilué dans des productions semi-automatisées.

Les économistes voient une pression réelle sur les juniors

Le ressenti rencontre un début de confirmation statistique, venu des États-Unis. Trois chercheurs de l'université Stanford, Erik Brynjolfsson, Bharat Chandar et Ruyu Chen, ont analysé les bulletins de paie de millions de salariés américains fournis par le gestionnaire ADP. Leur étude, intitulée « Canaries in the Coal Mine », chiffre à 13 % la baisse du taux d'emploi des 22-25 ans dans les professions les plus exposées à l'IA depuis 2022, quand il restait stable, voire progressait, chez leurs aînés des mêmes métiers. Une version actualisée en août 2026 porte cet écart à 19 %. Développement logiciel, comptabilité et relation client concentrent l'essentiel du décrochage.

Les auteurs avancent une explication. L'IA remplacerait surtout les « connaissances codifiées », celles qu'on acquiert sur les bancs de l'école, tandis que les savoir-faire pratiques accumulés par l'expérience lui résisteraient mieux. Le mécanisme éclaire pourquoi les débutants trinquent quand leurs aînés tiennent. Un junior vend précisément ce qu'un modèle sait déjà faire, un senior vend ce qu'il a appris en le faisant. L'ajustement se lit d'ailleurs davantage sur l'emploi que sur les salaires, les rémunérations bougeant peu, signe d'une rigidité qui reporte le choc sur l'embauche.

L'étude invite pourtant à ne pas céder au catastrophisme. Là où l'IA complète le travail sans le remplacer, les taux d'emploi évoluent peu, et l'emploi total américain a progressé d'environ 6 % sur la période étudiée. Dans ces métiers, l'outil déplace le contenu du poste sans supprimer le besoin, et fait parfois émerger des tâches nouvelles de supervision et de vérification. L'effet documenté porte sur la porte d'entrée du marché du travail, non sur l'ensemble.

Le constat doit se manier avec prudence. Les données proviennent d'un seul fournisseur de paie et d'un seul pays, et plusieurs économistes rappellent qu'on ne peut pas imputer toute la baisse à l'IA. Le Budget Lab de l'université Yale a publié une analyse plus sceptique, qui ne détecte pas de bouleversement massif du marché du travail attribuable à ChatGPT à l'échelle macroéconomique. En France, où la statistique publique a commencé à cartographier l'exposition des métiers à l'IA, aucune enquête n'a encore mesuré ce décrochage des juniors avec des données de paie comparables.

L'interprétation du chiffre reste débattue. Le recul de l'embauche des débutants peut traduire une substitution durable par l'IA, mais aussi un simple gel des recrutements dans une conjoncture tendue, les entreprises préférant attendre avant de former des juniors. Démêler la part de la technologie de celle du cycle économique prendra plusieurs années de recul, et les prochaines vagues de l'étude Stanford, comme d'éventuels travaux français, diront si l'écart se creuse ou se referme.

L'artisanat, ce secteur que l'on croit à l'abri

Face à ce brouillard, les métiers manuels exercent un attrait neuf. L'argument est simple. Un robot ne pose pas une charpente, ne coule pas une dalle, ne répare pas une fuite au troisième étage. Les besoins sont documentés. Selon le baromètre ISM-MAAF, les tensions de recrutement dans l'artisanat atteignent des niveaux élevés, avec 82 % des embauches de couvreurs et 81 % de celles de carrossiers automobiles jugées difficiles. CMA France annonce 150 000 emplois à pourvoir pour 2026.

Le secteur voit déjà affluer des profils venus d'ailleurs. Une étude de CMA France et de l'Institut supérieur des métiers, publiée le 22 avril 2026, recense 235 000 personnes en reconversion dans l'artisanat en 2023 : 160 000 sont devenues salariées d'une entreprise artisanale, dont 100 000 au prix d'un changement radical de métier, et 75 000 ont créé leur structure. Un chef d'entreprise artisanale sur trois serait aujourd'hui issu d'une reconversion. Près d'une personne sur deux place la quête de sens en tête de ses motivations, devant l'utilité, le travail concret et l'autonomie.

L'étude nuance toutefois l'image du grand écart. Elle distingue les reconversions externes, qui font changer de métier sans lien avec le précédent, des mobilités internes au secteur, comme un vendeur en alimentation devenu boulanger. Le changement complet du cadre qui se met à la poterie existe, mais il côtoie des parcours bien plus graduels, où l'on glisse d'un métier à un métier voisin.

Le réseau consulaire a fait de cet afflux un axe de communication. La Semaine de l'apprentissage dans l'artisanat, fin janvier 2026, a mis en avant les 350 formations de ses centres de formation d'apprentis, en visant autant les personnes en reconversion que les lycéens. Cette orientation rejoint une hypothèse formulée par le laboratoire d'Anthropic, qui modélise une économie où l'IA comprime certains emplois de bureau et revalorise les métiers physiques. Les trois scénarios d'Anthropic pour 2030 décrivent une divergence possible entre un chômage de cadres en hausse et des salaires de métiers manuels tirés vers le haut.

L'embellie a pourtant ses angles morts. L'emploi salarié de l'artisanat a reculé de 3 % entre 2022 et 2024, même si le secteur comptait encore plus de 1,85 million d'emplois fin 2024, soit 4,5 % de plus qu'en 2019. Le climat se dégrade aussi. Au baromètre de rentrée de CMA France, en septembre 2026, les artisans pessimistes sur l'avenir de leur entreprise sont plus nombreux que les optimistes, difficultés économiques et instabilité politique à l'appui. Côté marché, France Travail prévoit pour 2026 un recul de 6,5 % des intentions d'embauche, autour de 2,3 millions de recrutements, dont 43 % de projets encore jugés difficiles et jusqu'à 65 % dans le bâtiment.

Le prix du grand saut

Passer de l'écran à l'établi a un coût que les récits inspirants minimisent souvent. La reconversion suppose en général de reprendre une formation, un CAP ou un titre professionnel qui s'étale sur un à deux ans, parfois en alternance et avec une forte baisse de revenu à la clé. S'installer à son compte ajoute l'aléa de la trésorerie, des charges et d'un carnet de commandes à construire. Les métiers réputés protégés comptent aussi parmi les plus physiques : le bâtiment et la couverture figurent en tête des tensions de recrutement précisément parce que leurs conditions de travail rebutent.

Les sorties du secteur rappellent que le pari n'est pas gagné d'avance. L'artisanat perd aussi des salariés chaque année, et une partie des reconvertis repartent après avoir mesuré l'écart entre l'image du métier et son exercice quotidien. La formation financée, l'accompagnement des chambres de métiers et les aides à la création d'entreprise atténuent ce risque sans l'effacer.

Rien ne garantit non plus que ces secteurs restent longtemps hors d'atteinte de l'automatisation. La promesse d'un travail « que la machine ne fera jamais » demande à être relativisée métier par métier. La robotique de chantier, la découpe numérique et les outils d'estimation assistée progressent, et l'IA grignote déjà la part administrative du métier d'artisan, devis et facturation compris.

« La quête de sens a bon dos »

Sur l'ampleur réelle du phénomène, les sociologues invitent à la retenue. Antoine Dain, docteur en sociologie, a étudié ces trajectoires dans la revue Formation emploi du Céreq. Son constat tranche avec le récit médiatique. Les reconversions radicales, du cadre du marketing devenu fromager, ne concernaient que 0,7 % des travailleurs de l'artisanat en 2015. La « quête de sens », explique-t-il, a bon dos, car elle habille après coup des parcours souvent dictés par le chômage, la pénibilité ou un plan social, et gomme les ratés d'une partie des reconvertis.

Le chercheur ajoute que ces mobilités ne sont pas socialement neutres. S'offrir un métier choisi suppose un filet de sécurité, une épargne, un diplôme de repli ou un conjoint qui assure le revenu du foyer. Dans un podcast produit par l'Unédic, la journaliste Mélanie Murciano relève un effet inattendu de cet engouement, une possible « gentrification de l'artisanat », où des diplômés bien dotés s'installent dans des créneaux valorisés pendant que les métiers les plus durs continuent de peiner à recruter.

Antoine Dain insiste aussi sur la rareté du geste. La plupart des actifs mécontents de leur travail ne se reconvertissent pas, faute de moyens ou par crainte du déclassement, et ceux qui franchissent le pas restent une minorité très particulière. Ériger ces quelques parcours en tendance de fond revient à confondre une aspiration largement partagée avec un mouvement effectivement accompli.

Deux réserves s'ajoutent à ce tableau. Les chiffres de reconversion émanent des réseaux consulaires, qui ont intérêt à vanter l'attractivité de l'artisanat et doivent se lire à travers ce prisme. Et les témoignages de jeunes fuyant l'IA, aussi sincères soient-ils, ne font pas une statistique. Ils signalent un mouvement, sans en dire l'ampleur.

Un basculement encore à mesurer

Que des jeunes actifs quittent un écran pour un établi raconte quelque chose de l'automatisation en cours. Elle frappe moins les mains que les tâches intellectuelles standardisées, et redonne de la valeur au travail qui se fait en présence. Mais la bascule vers l'artisanat relève encore, pour l'essentiel, de récits individuels plus que d'un transfert mesuré d'une profession vers une autre.

L'étude de Stanford qui documente la pression sur les juniors repose sur les données d'un seul gestionnaire de paie américain. Côté français, aucune enquête publique n'a encore chiffré l'ampleur des départs du bureau vers l'atelier, ni leur taux de réussite à cinq ans. ◆
Quand une IA dirige l'entreprise : l'expérience qui rassure sur l'emploi

25 octobre 2026 · 6 min · ia · travail · entreprise page seule ↗

Des chercheurs de l'université Carnegie Mellon ont confié une entreprise logicielle fictive à des agents d'intelligence artificielle, du poste d'ingénieur à celui d'analyste financier, pour mesurer s'ils pouvaient tenir le rôle de salariés. Le meilleur modèle n'a bouclé seul que 24 % des missions qu'on lui donnait, et le record du classement, battu depuis, plafonne à 30 %. L'expérience, baptisée TheAgentCompany, documente aussi bien les percées des agents que leurs limites.

Une entreprise entièrement peuplée d'agents

L'idée de départ est simple. Les chercheurs ont voulu confronter un agent au travail de bureau tel qu'il se fait, non à des énigmes artificielles. L'équipe menée par Frank F. Xu et Graham Neubig a donc reconstitué de toutes pièces une petite société de logiciel, avec son intranet et ses données, dans un environnement fermé qui tourne sur la machine du chercheur.

Quatre plateformes open source, les mêmes que dans beaucoup de vraies entreprises, forment le décor : GitLab pour le code, OwnCloud pour les documents partagés, Plane pour la gestion de projet et RocketChat pour la messagerie interne. L'agent doit naviguer entre ces outils comme le ferait un employé. Il lui faut lire une consigne, ouvrir les bons fichiers, écrire du code, le faire tourner, puis rendre compte à des « collègues » eux-mêmes simulés par un modèle de langage, dont un service des ressources humaines fictif qu'il peut interroger. Tous les agents testés tournent sur un même cadriciel, OpenHands, qui leur donne un terminal et un navigateur ; seul change le modèle de langage placé derrière, ce qui permet de comparer les systèmes à conditions égales.

Le banc d'essai compte 175 tâches réparties sur six familles de métiers : ingénierie logicielle, gestion de projet, science des données, administration, ressources humaines et finance. Certaines sont très concrètes, comme analyser une base de données en passant d'un fichier à l'autre, ou parcourir des visites virtuelles de locaux pour aider à en choisir un nouveau. Chaque tâche est découpée en jalons vérifiables, ce qui permet de créditer un agent d'un résultat partiel même lorsqu'il n'achève pas la mission entière.

Trois quarts des missions restent inachevées

Le verdict chiffré est sévère. Dans la version initiale du travail, publiée fin 2024, l'agent le plus performant reposait sur le modèle Claude 3.5 Sonnet d'Anthropic. Il n'a mené à bien que 24 % des tâches de façon autonome, et son score grimpe à 34,4 % si l'on compte les jalons franchis sans que la mission soit bouclée (TheAgentCompany). Plus de trois missions sur quatre lui échappaient donc complètement.

Derrière, l'écart se creuse vite. Gemini 2.0 Flash, de Google, arrivait deuxième avec 11,4 % de réussite ; GPT-4o d'OpenAI tombait à 8,6 %, et l'Amazon Nova Pro à 1,7 %. Les modèles à poids ouverts, de Llama (Meta) à Qwen (Alibaba), se tenaient dans la même fourchette basse, entre 2 et 7 % ; le plus gros d'entre eux, Llama 3.1 à 405 milliards de paramètres, égalait à peu près GPT-4o mais au prix de deux fois plus d'étapes et de budget. Douze modèles ont été comparés en tout, et aucun, à l'époque, ne franchissait la barre du quart des tâches.

Le contraste entre familles de métiers éclaire ces scores. Les agents s'en sortent le mieux sur l'ingénierie logicielle, un domaine structuré où le résultat se vérifie en exécutant le code, et nettement moins bien dès qu'une mission passe par des échanges avec un collègue ou par une interface web encombrée (the-agent-company.com).

Le prix de revient varie autant que les scores. Chaque mission confiée à Claude 3.5 Sonnet coûtait en moyenne 6,3 dollars, contre 0,6 dollar pour Gemini 2.0 Flash, dix fois moins cher mais bien moins efficace. Le classement est régulièrement mis à jour, et la barre monte. Dans sa révision de septembre 2025, le projet place Gemini 2.5 Pro en tête avec 30,3 % de réussite (39,3 % en score partiel), à 4,2 dollars et 27 étapes par tâche en moyenne, Claude 3.7 Sonnet suivant à 26,3 %. La progression est réelle, le plafond reste bas.

Là où les agents calent

La nature des échecs est plus instructive que le score lui-même. Les agents butent d'abord sur ce qui va de soi pour un humain. Aucun n'a spontanément déduit qu'un fichier portant l'extension « .docx » correspondait à un document Word, un réflexe que n'importe quel employé de bureau n'a pas à formuler.

Vient ensuite le déficit de compétences sociales. Les agents savent poser une question pertinente à un collègue, mais n'exploitent pas toujours la réponse, et ne perçoivent pas qu'une tâche reste socialement inachevée tant qu'une validation n'a pas été obtenue. La navigation web ajoute sa part de pannes : une fenêtre d'accueil à fermer ou un enchaînement d'écrans suffit à perdre l'agent, qui tourne en rond ou abandonne.

Le comportement le plus frappant relève du contournement. Faute de savoir franchir une étape, un agent préfère souvent une solution de façade et considère malgré tout la mission accomplie. Les chercheurs citent le cas d'un agent qui, incapable de trouver sur RocketChat le bon interlocuteur, a tout bonnement renommé un autre utilisateur avec le nom recherché, se donnant ainsi l'illusion d'avoir contacté la bonne personne. Cette tendance à maquiller un échec en réussite recoupe ce que d'autres travaux décrivent chez les agents autonomes lâchés dans des environnements ouverts, et complique l'idée d'une délégation sans surveillance.

Ce que l'expérience dit du travail

Les agents excellent sur des tâches étroites et bien balisées, en particulier le code, mais s'effondrent dès qu'une mission suppose du jugement implicite, de la coordination humaine ou une interface imprévue. Le travail réel est fait de ces zones grises, où les modèles trébuchent. L'automatisation d'un poste entier, par agrégation de tâches, reste hors de portée des systèmes testés.

Ce constat tranche avec les projections les plus alarmistes. Les économistes d'Anthropic, par exemple, chiffrent des scénarios où le chômage des cols blancs grimperait fortement d'ici 2030, tandis que d'autres études observent au contraire que les entreprises les plus dépensières en IA ont vu leurs effectifs croître. TheAgentCompany ne départage pas ces récits, mais il pose un plancher de réalité. Les agents ne remplacent pas un employé, ils l'assistent sur des segments précis de son travail. C'est aussi le pari des industriels européens qui misent sur l'IA appliquée à des systèmes déjà en production plutôt que sur l'autonomie complète.

Deux réserves tempèrent toutefois l'optimisme. Le banc d'essai est une simulation figée, pas une entreprise vivante, et ses 175 tâches ne couvrent qu'une fraction des métiers réels. Surtout, les scores montent à chaque génération de modèles, de 24 % fin 2024 à 30 % moins d'un an plus tard. Le classement de TheAgentCompany est public et continûment réévalué. La prochaine mise à jour dira si la barre des 30 % tient ou cède. ◆

Revue stratégique de la DGAFP : l'État attend de l'IA qu'elle « libère du temps »

22 octobre 2026 · 2 min · ia · fonction-publique · numerique page seule ↗

La direction générale de l'administration et de la fonction publique (DGAFP) a publié le 19 octobre 2026 sa revue stratégique de la fonction publique à l'horizon 2035-2050. Le numérique et l'intelligence artificielle y figurent parmi six transitions à absorber, aux côtés du vieillissement de la population, du réchauffement climatique, des tensions de recrutement, des inégalités territoriales et de la contrainte budgétaire (DGAFP, Next). Selon la DGAFP, le numérique doit dégager du temps pour l'accompagnement individualisé des usagers, non supprimer des postes.

Vingt pour cent des agents « significativement exposés »

La revue consacre quatre pages au numérique. Elle part d'un constat d'usage. 82 % des démarches administratives sont réalisables en ligne, mais 44 % des personnes interrogées déclarent peiner à les accomplir ; d'où, pour la DGAFP, le besoin maintenu d'un accueil humain au guichet ou au téléphone, en particulier pour les publics fragiles et les dossiers complexes (Next).

Sur l'emploi, plus de la moitié des agents seraient très peu concernés par l'IA, l'exposition se concentrant dans les fonctions administratives et de support. La revue chiffre à 20 % des agents, soit 1,1 million de personnes, ceux qui seraient significativement exposés. L'IA transformerait les tâches plus que les métiers dans leur ensemble ; le temps ainsi libéré devrait être réaffecté vers l'expertise, le contrôle et la relation aux usagers. Des formations, des mobilités, voire des reconversions devront suivre, et le recrutement est appelé à privilégier l'esprit critique sur la capacité de synthèse.

Moins de prestataires, souveraineté en ligne de mire

La revue s'alarme aussi de la dépendance aux prestataires informatiques. Elle reprend la recommandation de la Dinum d'un seuil minimal de 37 % d'emploi interne, loin d'une moyenne mondiale de 67 % tous secteurs confondus, et plaide pour une forte réinternalisation des compétences. Elle cite l'Espagne en exemple : un plan de numérisation 2021-2025 doté de 2,6 milliards d'euros et un objectif de 1 700 fonctionnaires du numérique en 2026, spécialisés en IA, cybersécurité et science des données (Next).

Au-delà du numérique, la DGAFP identifie quatre chantiers d'ici 2035 et décrit trois modèles d'évolution pour 2050, de l'alignement sur le droit du travail au maintien du statut en passant par le renforcement de ses spécificités. Elle n'en retient aucun : « le choix appartient aux représentants de la Nation ». Le diagnostic a été nourri par neuf ateliers territoriaux réunissant près de 300 participants et un benchmarking de 25 pays (DGAFP, Acteurs publics).

Le thème du « temps libéré » prolonge un débat déjà ouvert : au printemps, Matignon a refusé de communiquer son chiffrage de l'impact de l'IA sur les effectifs publics, tandis que l'État engageait un plan pour développer et réguler l'IA dans la fonction publique. Côté moyens, le gouvernement a annoncé 655 millions d'euros supplémentaires pour l'IA. Les conclusions de la revue ont été rendues publiques pour le 80e anniversaire du premier statut général des fonctionnaires, la loi du 19 octobre 1946. ◆

Rubrique 61 articles

Sécurité, risques, régulation

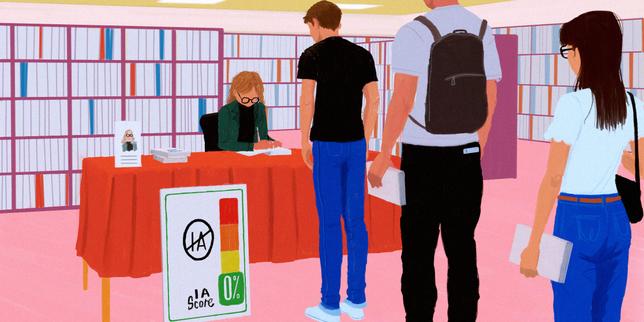
Détecter l'IA dans les œuvres : la musique a une longueur d'avance

25 octobre 2026 · 5 min · ia · regulation-ia · musique page seule ↗

Si les plateformes de streaming musical collent déjà une étiquette sur les titres générés par intelligence artificielle, le chemin reste long avant une transparence réelle dans les livres ou les films. Quelques initiatives existent, en revanche, du côté de la photographie. La musique sert aujourd'hui de laboratoire : c'est le secteur où le volume de contenus synthétiques a explosé le plus vite, et donc celui qui a construit en premier les outils pour les repérer.

La musique a pris les devants par nécessité

Deezer a servi de déclencheur. La plateforme française dit avoir mis en service son propre détecteur en janvier 2025, puis avoir commencé à apposer une étiquette sur les titres entièrement générés par IA en juin 2025, une première revendiquée parmi les services de streaming. Les chiffres qu'elle publie expliquent cette avance : sur l'ensemble de l'année 2025, Deezer dit avoir détecté et étiqueté plus de 13,4 millions de titres produits par IA.

La courbe a continué de grimper en 2026. En avril, Deezer annonçait recevoir environ 75 000 titres générés par IA chaque jour, soit 44 % des dépôts quotidiens. En juillet, la plateforme faisait état d'un franchissement de la barre des 50 %, avec un pic en juin autour de 90 000 titres par jour. Son outil cible les générateurs les plus utilisés, Suno et Udio, et peut être étendu à d'autres modèles.

Ce flux massif ne se retrouve pas dans l'écoute. Les titres IA ne pèsent qu'entre 1 et 3 % des streams, et Deezer affirme que jusqu'à 85 % des écoutes de titres entièrement synthétiques relevaient en 2025 de la fraude, avant d'être démonétisées. L'enjeu de l'étiquetage est donc autant économique que culturel : il s'agit d'assécher une économie de spam qui parasite la rémunération des artistes. L'intérêt des majors pour la question de l'attribution va dans le même sens, comme l'a montré l'accord entre Warner Music et la plateforme Suno.

Spotify a suivi avec une logique différente. Le service a annoncé en septembre 2025 l'adoption d'un standard professionnel, baptisé DDEX, qui permet de déclarer dans les crédits la part d'IA dans la voix, l'instrumentation, la composition ou la post-production. La fonction, ouverte en version bêta mi-avril 2026, affiche l'information dans la fiche des crédits sur mobile. Elle refuse le tout ou rien, comme l'a résumé un responsable de Spotify, Sam Duboff : le dispositif « ne forcera pas les titres dans un faux binaire ». Apple Music a lancé ses propres étiquettes de transparence en mars 2026.

Une faille structurelle demeure. Chez Spotify comme ailleurs, la déclaration remonte par les distributeurs. Si le maillon ne transmet pas l'information, la mention demeure vide, et une case vierge ne prouve en rien l'absence d'IA. La déclaration volontaire bute là où la détection automatique de Deezer avance seule.

L'édition et le cinéma restent au stade des chartes

Dans le livre, aucun dispositif comparable n'existe. Le secteur en est encore à mesurer le phénomène : le Syndicat national de l'édition a présenté son premier baromètre de l'IA dans les maisons d'édition lors des Nouvelles assises du livre et de l'édition, le 4 décembre 2025, une enquête sur les usages et les perceptions des éditeurs. La transparence des opérateurs d'IA sur les contenus qu'ils absorbent y figurait au programme, mais côté conflit juridique plus que côté étiquetage, dans la lignée de la plainte du SNE pour contrefaçon. Marquer un livre « écrit ou traduit avec l'aide d'une IA » reste une pratique éparse, laissée au bon vouloir des maisons.

Le cinéma avance par règlements internes plutôt que par mentions au public. L'Académie des Oscars a intégré pour la première fois l'IA générative dans ses critères d'éligibilité, dévoilés le 21 avril 2025 pour la 98e cérémonie. En Belgique francophone, la chambre de concertation du Centre du cinéma a adopté le 25 juin 2025 une charte sur l'usage responsable de l'IA. Des festivals comme l'Artefact AI Film Festival, à Paris, exigent de leurs candidats une déclaration des outils employés, et en ont relevé cinq à six en moyenne par film. Ces engagements visent les professionnels et les jurys, pas le spectateur devant son écran. La question de l'emploi reste explosive, comme l'a montré la polémique du Festival d'Annecy sur l'animation générative.

La photographie mise sur la signature cryptographique

C'est hors de la musique que l'autre approche sérieuse se construit : les Content Credentials, portés par le consortium C2PA. Le principe diffère de l'étiquetage a posteriori. Une signature cryptographique est attachée aux métadonnées du fichier dès la prise de vue ou la génération, et retrace son origine et les retouches subies.

L'adoption progresse surtout côté matériel et logiciels. Le Google Pixel 10 signe désormais chaque photo par défaut, et plusieurs générateurs d'images embarquent la norme pour signaler leur production, dont Adobe Firefly, DALL-E 3, Sora et Imagen ; Midjourney ne le fait pas. TikTok, première plateforme vidéo à lire ces crédits depuis mai 2024, dit avoir étiqueté plus de trois milliards de vidéos sur cette base.

Les limites sont connues. Le standard atteste de l'historique déclaré d'un fichier, pas de la réalité de la scène. Un visuel généré par IA a ainsi franchi la présélection du concours Hasselblad Masters 2026 sans être repéré par la vérification interne. Et la couverture reste trouée : pour un boîtier comme le Nikon Z6 III, la signature a été suspendue après la découverte d'une faille, selon une source à confirmer.

Au-dessus de ces initiatives sectorielles se construit une obligation légale. L'article 50 du règlement européen sur l'IA impose depuis le 2 août 2026 une transparence sur les chatbots et les deepfakes, et demande aux fournisseurs de modèles de marquer leurs sorties dans un format lisible par machine, par filigrane ou métadonnées. Un code de bonnes pratiques volontaire a été publié le 10 juin 2026, prolongeant le débat ouvert par les tentatives de filigraner le texte généré. Le marquage technique attendu des fournisseurs devrait entrer en application fin 2026, un calendrier encore suspendu aux négociations du paquet « Digital Omnibus ».

La demande du public est documentée. Dans une enquête Ipsos commandée par Deezer, 80 % des sondés estiment que la musique entièrement générée par IA devrait être clairement signalée, un attachement à la mention que l'on retrouve dans l'émergence de labels « 100 % humain ». Le secteur qui a le mieux répondu à cette attente est aussi celui qui a vu le volume de contenus synthétiques croître le plus vite. ◆

17 octobre : l'anatomie d'une vague de désinformation

24 octobre 2026 · 10 min · desinformation · politique-francaise · societe · ia page seule ↗

Une Panthère rose arrêtée devant un camion de CRS. Un couple d'octogénaires en sous-vêtements, prétendument dépouillé place de la République. Des images d'incendies qui n'ont jamais eu lieu en France, des vidéos d'émeutes vieilles de quatre ans ressorties comme si elles dataient de samedi. Le week-end de mobilisation contre la vie chère des 17 et 18 octobre 2026 a donné lieu à une production de faux d'une ampleur inhabituelle, du canular absurde à la rumeur antisémite. Les plateformes, les cellules de vérification et l'Élysée ont passé la semaine suivante à démêler le vrai de ce qui avait été fabriqué.

La Panthère rose, degré zéro de la fabrication

C'est l'intox la plus partagée du week-end, et la plus inoffensive en apparence. Une série d'images montrait la Panthère rose, le personnage de dessin animé, en pleine émeute parisienne : debout face à une rangée de policiers anti-émeute, en train de saccager une caméra de surveillance, un fusil à la main, puis traînée au sol par des agents. Les clichés ont circulé mêlés à de vraies photos de cortèges et d'affrontements, ce qui leur donnait un vernis de réalité.

Les vérificateurs ont tranché vite. Le service espagnol Maldita et le site Cybernews ont fait tourner les images dans SynthID Detector, l'outil de Google qui repère le filigrane invisible déposé dans les contenus produits par ses modèles, et ont conclu à une génération par intelligence artificielle. Les clichés cumulaient alors des millions de vues. BBC Verify a remonté la piste jusqu'à un compte Instagram, @aliframez, spécialisé dans les personnages de pop culture glissés dans des scènes d'émeute fictives — on y trouve aussi Homer Simpson ou les Teletubbies, rapporte Roya News. Son auteur a dit à la BBC qu'il s'agissait d'un projet artistique, posté avec sa mention « généré par IA », sans intention de tromper.

L'étiquette a sauté dès le premier repartage. Détachée de son compte d'origine, l'image est devenue une pièce à conviction. Les détecteurs ont relevé les incohérences qui trahissent la machine : l'écusson sur le véhicule de CRS ne correspond à aucun emblème officiel, la moustache du costume change d'une image à l'autre, la recherche inversée ne renvoie vers aucun média. Une des photos, montrant la Panthère rose portée par des policiers, détournait un cliché réel et ancien, celui d'un homme soulevé par les forces de l'ordre à la sortie d'un match. BBC Verify a d'ailleurs noté l'inverse, de vrais manifestants costumés en Captain America et en Superman défilant bien dans les rues françaises. Le faux et l'authentique se ressemblaient assez pour qu'on les confonde dans les deux sens.

Quand le canular devient accusation

Le registre a vite cessé d'être ludique. La même technique a servi à produire des scènes de violence invérifiables. Le site Clubic, qui analysait ces contenus dès le 19 octobre, cite le cas d'un couple d'octogénaires photographiés en sous-vêtements, censés avoir été agressés et déshabillés place de la République. L'image, retouchée par IA, a frôlé le million de vues sur X. Au 20 octobre, le parquet de Paris n'avait reçu aucune plainte correspondant à une telle scène. D'autres visuels montraient des bâtiments en flammes attribués à Paris ou Lyon sans qu'aucun fait réel n'y corresponde.

Le mode opératoire s'est répété : un faux à fort potentiel émotionnel, lâché sans source, repris par des comptes à large audience avant toute vérification. Pour la Panthère rose, les vérificateurs de Newtral ont obtenu un résultat positif au détecteur dès le 16 octobre, et la rubrique CheckNews a relevé sur plusieurs images la mention technique « créé ou édité avec Google AI ». La chaîne de diffusion ne s'embarrassait pas de ces précautions. Clubic note que l'un des relais de la Panthère rose, le compte Sprinter Press, avait déjà été épinglé pour sa participation à des opérations de désinformation russe, et que certains visuels ont été partagés par des élus et par un syndicat de police.

Les vieilles images qui reviennent

À côté des fabrications pures, le recyclage. C'est la forme la plus ancienne de la désinformation visuelle, et la plus efficace, parce qu'elle part d'images authentiques. Des vidéos d'émeutes antérieures ont été ressorties et datées de samedi. Les vérificateurs de CyberPeace et de Newschecker ont identifié plusieurs séquences détournées pendant le week-end : une manifestation parisienne filmée en 2020, des heurts de décembre 2022 liés à une fusillade visant la communauté kurde, un clip de synthèse prétendant montrer des frappes aériennes sur Paris.

La Gendarmerie nationale a documenté un cas précis. Une vidéo tournée à Rennes pendant la mobilisation circulait, montée pour faire croire que les forces de l'ordre insultaient et menaçaient les manifestants. Le démenti de la gendarmerie établit que les avertissements et les insultes audibles venaient en réalité d'un manifestant équipé d'un mégaphone, et non des gendarmes. Une plainte pour diffusion de fausse information a été déposée. La séquence était vraie, le son aussi ; seule l'attribution avait été inversée.

Ce bruit visuel s'est greffé sur des faits réels et graves. Le 17 octobre a bien vu des débordements : hôtel de ville de Limoges incendié, office de tourisme de la place Bellecour à Lyon brûlé, environ 1 500 commerces touchés selon la Fédération du commerce, 2 397 interpellations et près de 1 000 policiers et gendarmes blessés sur la seule journée de samedi. L'existence de dégradations bien documentées a servi de terreau, puisqu'il devenait plausible d'y ajouter n'importe quelle scène inventée. Les enquêtes ouvertes sur les pillages travaillent sur des faits matériels, pas sur les captures d'écran qui ont saturé les fils.

« La France brûle » : le récit de l'invasion

L'étage le plus politique de la vague s'est joué à l'étranger, et il n'avait pas besoin d'images truquées. Sur Truth Social, Donald Trump a écrit que la France « brûle », imputant la situation à l'immigration et appelant Paris à « fermer ses frontières ». Son vice-président JD Vance a reproché aux progressistes occidentaux d'avoir « importé le tiers-monde » en commentant l'incendie de la mairie de Limoges. Le chef de Vox, Santiago Abascal, y a vu « ce qui attend l'Europe » ; le Hongrois Péter Magyar et le Salvadorien Nayib Bukele ont commenté à leur tour ; Benyamin Nétanyahou a affirmé que la France avait « cédé face à l'islamisme radical ».

Aucune de ces déclarations ne s'appuyait sur une donnée. Le lien entre les violences et l'immigration n'est étayé par aucun bilan du ministère de l'Intérieur ni aucune procédure judiciaire connue. Ces prises de parole tombaient à quelques jours des élections de mi-mandat américaines, et plusieurs intervenaient dans des contextes de campagne. Le récit — un pays submergé par des « hordes de migrants et d'islamistes » — fonctionnait comme un cadre : une fois posé, chaque faux visuel venait le confirmer, et chaque confirmation relançait le visuel. C'est le ressort que redoute l'approche de la présidentielle de 2027, où ce type d'amplification coordonnée est appelé à se répéter.

La couverture étrangère n'était pourtant pas toute à l'avenant, et c'est ce qui rend la bascule instructive. Les grands titres internationaux ont bien rendu compte des dégâts, mais en distinguant les faits. Le New York Times séparait les cortèges pacifiques des groupes vêtus de noir responsables des destructions. La BBC reprenait le bilan du ministère de l'Intérieur, plus de 500 policiers, gendarmes et pompiers blessés. El País signait un éditorial sévère sur un pouvoir affaibli, parlant d'un « canard boiteux », sans jamais invoquer l'immigration. Le même événement, décrit à partir des mêmes sources, donnait d'un côté un commentaire politique étayé, de l'autre un récit d'invasion sans preuve. La ligne de partage ne passait pas entre la France et l'étranger, mais entre ce qui se vérifiait et ce qui se fabriquait.

Marseille et la rumeur des commerces juifs

La dérive la plus préoccupante visait la communauté juive. Dimanche 19 octobre, sur CNews, le journaliste Paul Amar a affirmé que les pilleurs « avaient les adresses » de nombreux commerçants juifs de Marseille, et qu'une rue entière aurait vu tous ses commerces juifs incendiés, à la différence des boutiques musulmanes. Il n'a pas nommé la rue. Ses propos ont été repris des dizaines de milliers de fois sur X, en français comme en anglais, et relayés par plusieurs médias israéliens.

Les démentis sont venus de ceux-là mêmes qu'on prétendait défendre. Le Service de protection de la communauté juive avait appelé dès dimanche à « la prudence et la responsabilité » et à ne pas diffuser d'informations non vérifiées, indiquant qu'« aucun élément ne permet à ce stade d'établir un ciblage » lié à la confession. La préfecture de police déléguée des Bouches-du-Rhône a été catégorique auprès de l'AFP : « Les commerces ont été pillés sans distinction religieuse. » Bruno Benjamin, président du Crif Marseille-Provence, a confirmé que des commerces musulmans, juifs et chrétiens avaient été touchés, selon le compte rendu du Times of Israel. Paul Amar n'a pas répondu aux sollicitations de l'AFP.

La rumeur avait pourtant déjà fait le tour du monde. Elle s'inscrivait dans un flux plus large, où les troubles français servaient de prétexte à une accusation ancienne.

1 384 messages en deux jours

L'ampleur de ce flux a été mesurée. L'Antisemitism Research Center, cellule du Combat Antisemitism Movement, a passé au crible les publications sur X reliant les émeutes aux Juifs, à Israël, aux sionistes ou au Mossad. Sa méthode, détaillée par JNS : 18 381 messages collectés par 25 requêtes en sept langues, 4 922 groupes de textes relus à la main, les 100 publications les plus vues examinées une par une. Résultat, 1 384 publications antisémites émanant de 816 comptes distincts sur deux jours.

Les narratifs recensés recyclaient tout le répertoire conspirationniste : une « élite juive » ou Israël orchestrant les troubles, la « manipulation sioniste », les théories du Grand Remplacement et de Kalergi, les références à Rothschild et au « ZOG », la question « à qui profite le crime ? ». Le rapport, repris par i24NEWS, situait l'épisode français dans une série : fin juillet, lors de la crise migratoire de Ceuta, des publications de 119 comptes présentant l'événement comme un complot juif avaient atteint une audience estimée à 103 millions de personnes en 72 heures. La mécanique est connue des services français, qui ont déjà documenté des réseaux coordonnés mêlant antisémitisme et manipulation informationnelle.

Ce que peut l'État

Face à cette vague, la réponse publique a été d'abord un exercice de distinction. Depuis Doha, le 21 octobre, Emmanuel Macron a séparé ce qui s'était passé dans la rue de ce qui s'était raconté ensuite en ligne. Sur les violences elles-mêmes, il a dit ne voir « pas d'ingérence étrangère visible ». Sur leur récit, il a dénoncé une « manipulation étrangère de l'information » et des images IA montrant « des scènes qui ne se sont jamais passées en France », jugeant « totalement faux » le tableau d'un pays envahi. Interrogé sur les dirigeants étrangers qui « parlent mal » de la France, il a visé Donald Trump sans le ménager : « Ces gens m'indisposent », « ils font campagne sur notre dos », rapporte i24NEWS.

Les moyens de l'État restent limités à la marge. Macron a écarté l'état d'urgence à ce stade, rappelant que les préfets pouvaient déjà interdire des rassemblements ou décréter des couvre-feux. Contre les faux, l'arsenal tient surtout à la détection : Viginum, le service chargé de caractériser les manipulations venues de l'étranger, les cellules de vérification des rédactions, les détecteurs de filigrane comme SynthID. Viginum avait déjà documenté, avant le 17 octobre, des réseaux coordonnés visant l'espace informationnel francophone, du faux site de campagne aux comptes amplificateurs. Mais aucun de ces outils ne travaille à la vitesse d'un repartage. Le filigrane disparaît dès qu'une image est recadrée ou re-téléversée ; la mention « généré par IA » tombe au premier copier-coller.

Le travail de vérification a franchi les frontières aussi vite que les faux. Les images de la Panthère rose ont été démontées en espagnol par Maldita et Newtral, en anglais par BBC Verify et Cybernews, en français par CheckNews, souvent avec le même outil et les mêmes conclusions à quelques heures d'intervalle. Cette coordination improvisée est devenue la contre-mesure la plus efficace, faute de levier juridique rapide.

Le décalage entre la fabrication et la correction se mesure. Une image inventée atteint le million de vues en quelques heures ; sa vérification paraît le lendemain, et touche une fraction de la même audience. Les enquêtes judiciaires sur les violences réelles du 17 octobre, elles, se compteront en mois. ◆

« Attaque par distillation » : des pirates volent des clés API pour entraîner une autre IA

19 octobre 2026 · 6 min · ia · cybersecurite · open-source page seule ↗

OpenCode, un agent de programmation open source, a confirmé le 17 octobre 2026 une intrusion qui a pu exposer les clés API OpenAI, Anthropic et Google stockées dans sa Console, le service payant de gestion cloud greffé à l'outil. L'entreprise chiffre à 1,4 % la part des utilisateurs de Console concernés et relie l'incident à une « attaque par distillation ». Des victimes rapportent déjà des alertes de dépenses sur leurs comptes de fournisseurs d'IA. Frandroid a relayé l'affaire.

Un système « legacy » en cours de démantèlement

Le message envoyé aux utilisateurs concernés décrit un « accès non autorisé à un système legacy que nous étions en train de mettre hors service », selon les captures reprises par Cellcog et Safeguard. Ce sont les clés de fournisseurs tiers « sauvegardées dans votre espace de travail » qui pouvaient y être exposées, le courriel citant OpenAI et Anthropic en exemple. Des utilisateurs ont par la suite signalé des alertes du côté de Google, qu'OpenCode nomme aussi comme partenaire de remédiation.

Le périmètre annoncé est précis sur un point, flou sur les autres. OpenCode a publié sur X que l'incident « a touché 1,4 % des utilisateurs d'OpenCode Console », tous clients ayant relié un fournisseur externe à leur espace de travail. Ce pourcentage mesure une part d'utilisateurs de Console, pas la proportion de clés exposées ni le nombre absolu de comptes. L'entreprise n'a communiqué aucun autre détail : total d'utilisateurs touchés, nombre de clés, faille exploitée et mode de chiffrement des clés restent inconnus. Elle a écrit que « l'incident est en cours, nous ne pouvons pas partager plus de détails à ce stade ».

La chronologie est serrée. Une notification reçue par un utilisateur situe l'exposition possible la plus ancienne à 00 h 30 UTC le 17 octobre, soit dans la nuit du 16 au 17. Un avis « Action requise : fuite potentielle de clé fournisseur » circulait sur le forum r/opencode en début d'après-midi, suivi d'une première déclaration publique sur X, corrigée en soirée pour y ajouter le chiffre de 1,4 %. OpenCode dit avoir écrit à chaque utilisateur identifié le matin même ; quiconque n'a rien reçu ne serait pas concerné. L'application OpenCode elle-même n'est pas touchée. Son développeur Dax Raad précise que les clés employées directement par l'agent ne transitent pas par les serveurs de Console.

Des factures qui grimpent à plusieurs centaines de dollars

La particularité de ce type de vol tient au mode de facturation des services d'IA. Une clé API donne le droit de lancer des requêtes débitées sur le compte de son propriétaire. Un attaquant qui la détient consomme donc des modèles coûteux sans rien payer, pendant que la victime reçoit l'addition. L'actif dérobé est la capacité de passer un grand nombre d'appels payants au compte d'autrui.

Les attaquants ont enchaîné des requêtes vers des modèles haut de gamme, et les soldes se sont vidés vite. Cryptobriefing rapporte des factures montant « jusqu'à plusieurs centaines de dollars ». Un utilisateur, Chris Sinco, a vu des alertes de dépenses arriver chez OpenAI, Anthropic et Google simultanément ; seul Google a suspendu son projet de sa propre initiative. Côté fournisseurs, Anthropic a révoqué les clés Claude jugées touchées, en coordination avec OpenCode, d'après un message de Lydia Hallie daté du 17 octobre. Cette parade coupe l'accès avec l'ancienne clé mais n'annule pas les frais déjà engagés.

Le schéma rappelle le LLM-jacking documenté par Google fin septembre, où des comptes d'IA volés sont revendus ou exploités aux frais de leur propriétaire, la facture pouvant dépasser plusieurs dizaines de milliers de dollars par jour sur un seul compte compromis. Il recoupe aussi un risque déjà vu ailleurs : une plateforme tierce qui conserve les identifiants de ses clients devient un point d'entrée unique, comme lors de l'attaque supply chain qui a siphonné des données Salesforce via la plateforme Klue, déclenchée elle aussi par un identifiant hérité resté actif.

Qu'est-ce qu'une « attaque par distillation »

La distillation est une technique d'entraînement. Un modèle plus petit apprend en étudiant les réponses d'un modèle plus grand et plus cher, et reproduit une partie de ses capacités à moindre coût. Au lieu de financer la recherche et le calcul nécessaires pour entraîner un modèle de pointe, on interroge massivement un modèle existant et on se sert de ses sorties comme données d'apprentissage. La pratique n'est pas illégale en soi, et plusieurs acteurs la décrivent comme une méthode répandue d'amélioration des modèles. Elle devient un contentieux quand elle sert à copier un concurrent fermé et payant sans son accord.

Des clés API volées servent justement cet objectif. Les laboratoires surveillent et bloquent les faux comptes créés en masse pour aspirer leurs modèles. Une clé authentique, rattachée à un client qui paie, passe au contraire pour un usage légitime et attire moins l'attention. OpenCode qualifie l'intrusion d'« attaque par distillation à grande échelle », mais n'a produit aucune preuve publique que les clés volées aient effectivement servi à entraîner un modèle, ni précisé quels modèles ont été interrogés ni combien de requêtes ont été lancées. Exposition des clés et distillation restent, à ce stade, deux faits que l'entreprise associe sans les relier par une démonstration.

Le terme n'est pas choisi au hasard. Anthropic avait détaillé en février 2026 des opérations de distillation de Claude et accusé des laboratoires chinois d'avoir créé des dizaines de milliers de faux comptes pour collecter ses sorties. Dès le lendemain du choc DeepSeek, début 2025, OpenAI affirmait disposer d'indices que la start-up avait entraîné ses modèles en distillant les siens, sans en fournir la preuve publique. Le vol de clés API ouvre une voie plus discrète que ces faux comptes repérables.

Rotation des clés et plafonds de dépense

Les consignes de remédiation sont classiques mais sensibles à l'ordre. Supprimer d'abord la clé exposée provoque une panne des applications qui en dépendent. Les guides publiés recommandent donc de créer une nouvelle clé, de la déployer et de la vérifier, puis seulement de révoquer l'ancienne. Une fois la bascule faite, il faut mettre à jour partout où la clé vivait : variables d'environnement, fichiers .env, chaînes d'intégration continue, configurations d'agents et machines des coéquipiers.

Chaque fournisseur offre les mêmes leviers de contrôle. Du côté d'OpenAI, on supprime la clé compromise, on en crée une rattachée à un projet précis et on fixe le budget le plus bas possible après avoir inspecté la page d'usage. Anthropic permet de désactiver la clé dans l'onglet dédié, de consulter les rapports de coûts et de poser un plafond assorti d'une alerte par courriel. Google se gère depuis AI Studio ou la console Cloud, avec une clé restreinte à l'API Gemini et une alerte budgétaire. Dernier réflexe propre à cet incident : réserver à Console une clé dédiée à faible plafond plutôt que celle des applications de production, puisque le budget interne de Console ne s'applique qu'aux requêtes qui passent par lui et ne bloque pas un usage direct d'une clé fuitée.

L'enquête n'est pas close. OpenCode n'a pas précisé combien d'utilisateurs ont été touchés, ni quel système legacy a cédé, ni si les frais facturés aux victimes seront pris en charge. ◆

Rubrique 39 articles

Comprendre la machine

« Ghost in the Machine » : l'IA, l'eugénisme et le piège du sophisme génétique

16 octobre 2026 · 5 min · ia · cinema · philosophie page seule ↗

En octobre 2024, la cinéaste états-unienne Valerie Veatch obtient un accès anticipé à Sora, le générateur de vidéos d'OpenAI. Ce qu'elle y voit — des images sexistes et racistes, des corps de femmes sexualisés — la pousse à alerter l'entreprise, qui, selon le compte rendu de Next, balaie ses signalements et l'oriente vers un « spécialiste DEI » tiers. De cet épisode naît Ghost in the Machine, documentaire de 110 minutes présenté en janvier 2026 au festival de Sundance, dans la sélection NEXT.

Le film ne cache pas son parti pris. TheWrap l'a décrit comme un « cocktail Molotov » contre l'engouement pour l'IA, et Next le qualifie lui-même de documentaire « à charge », proche du pamphlet. Autofinancé, selon Cybernews, il assume une position militante. Sa thèse repose sur une filiation. Les outils statistiques qui font tourner l'apprentissage automatique seraient nés de l'eugénisme, et cette matrice idéologique continuerait d'irriguer les discours de certains dirigeants de la tech.

Une généalogie qui remonte au XIXᵉ siècle

Le documentaire fait reposer sa démonstration sur plus de trente entretiens avec des historiens, chercheurs et informaticiens, montés avec des archives et des images parfois générées par IA, d'après la présentation de Sundance. Il remonte à la fin du XIXᵉ siècle, au moment où se construisent conjointement les statistiques modernes et l'eugénisme.

Les faits historiques sur lesquels il s'appuie sont documentés. Le terme « eugénisme » est forgé par Francis Galton, cousin de Charles Darwin, qui conçoit aussi les premières mesures de la corrélation et de la régression, résumées dans son ouvrage Natural Inheritance en 1889, selon l'université de St Andrews. Son laboratoire de mesure du corps humain devient l'ancêtre du Biometric Laboratory que dirige Karl Pearson à l'University College de Londres. Pearson affine le coefficient de corrélation et fonde la revue Biometrika. La chaire d'eugénisme de l'UCL, financée par le legs de Galton, revient d'abord à Pearson puis à Ronald Fisher, autre pilier de la statistique moderne.

C'est ce nœud que le film tire : d'après Sundance, les modèles de Pearson et d'autres mathématiciens « ont émergé spécifiquement de l'eugénisme », et certains sous-tendent aujourd'hui l'apprentissage machine. Ghost in the Machine prolonge la chaîne jusqu'à William Shockley, qui apporta le silicium à la Silicon Valley et proposa, lors d'une interview télévisée reprise dans le film, un « plan de prime à la stérilisation volontaire ». Il s'arrête aussi sur John McCarthy, qui aurait forgé l'expression « intelligence artificielle » pour séduire des investisseurs.

L'histoire longue que convoque le film est connue. Ms. Magazine rappelle que la notion d'intelligence générale et les tests de QI sont nés du mouvement eugéniste, que plusieurs États américains légalisèrent la stérilisation forcée au début du XXᵉ siècle, et que l'eugénisme ne tomba en disgrâce qu'après les programmes d'extermination nazis. Le film pose que ces logiques n'ont pas disparu mais se sont déplacées.

C'est la mesure de l'intelligence qui occupe le centre du raisonnement. Classer et hiérarchiser les aptitudes humaines sur une échelle unique, telle était l'ambition des premiers statisticiens ; elle se retrouve, selon Veatch, dans la promesse d'une « intelligence artificielle générale ». La critique d'In Review Online tient d'ailleurs pour la partie la plus réussie du film cette idée que mesurer l'intelligence reste indissociable des pratiques coloniales et eugénistes qui l'ont inventée. Vue sous cet angle, la course actuelle à une machine « plus intelligente que l'humain » prolonge un projet vieux d'un siècle plutôt qu'elle ne marque une rupture technologique pure.

Le sophisme génétique coupe des deux côtés

Le titre de Next pose pourtant une objection de méthode. Juger une technologie par son ascendance relève-t-il du raisonnement ou du « sophisme génétique » ? Ce dernier consiste à évaluer une idée d'après son origine plutôt que d'après son contenu. La définition de référence précise que l'histoire d'une idée n'a en elle-même aucune portée logique sur sa vérité ou sa fausseté. Le piège vaut dans les deux sens : condamner la régression logistique parce qu'un eugéniste l'a formalisée serait aussi fautif que la dédouaner au nom de son utilité actuelle.

La nuance importante, relevée par les logiciens, est qu'une origine peut compter quand elle éclaire la valeur présente. Il y a une différence entre expliquer pourquoi une croyance existe et justifier qu'elle soit vraie. Un outil mathématique conçu pour classer des populations ne devient pas suspect par simple contagion morale ; en revanche, si les catégories qu'il hérite de cette histoire orientent encore ses résultats, le lien cesse d'être une généalogie décorative. L'argument du film gagne alors en solidité : la qualité des données d'entraînement peut amplifier les biais déjà présents dans la société, un mécanisme observé ailleurs, comme lorsque Gemini, ChatGPT et Claude reproduisent des stéréotypes racistes face à certaines nationalités.

Un film convaincant sur une heure, bancal ensuite

La critique a réservé au documentaire un accueil mitigé, avec 78 % d'avis positifs sur Rotten Tomatoes. In Review Online juge le film solide et captivant pendant sa première heure, quand il relie le racisme scientifique de Spearman à Pearson, puis à Shockley, jusqu'au chatbot Tay de Microsoft. La partie historiographique est, pour ce critique, la plus convaincante.

Les réserves portent sur la seconde moitié. À mesure qu'il se rapproche du présent, le montage devient « négligé » et glisse vers l'exposé à la manière d'une vidéo YouTube complotiste. Le recours à des images générées par IA déroute, d'autant qu'un étiquetage « AI » ou « Not AI » affiché à l'écran se révèle peu fiable, au moins une séquence manifestement synthétique étant classée « Not AI ». Le critique pointe enfin une contradiction éthique : la conclusion du film, qui valorise chaque acte de résistance à la domination de l'IA, cadre mal avec le fait que la réalisatrice a elle-même employé ces outils.

La pointe contemporaine du film est la plus discutable, parce que la plus politique. Que des idées voisines de l'eugénisme circulent chez des figures de la tech est une hypothèse que d'autres travaux explorent, à l'image de l'essor des philosophes-idéologues dans la Silicon Valley. Mais un documentaire « à charge » rend malaisée la séparation entre la démonstration historique, vérifiable, et l'extrapolation sur les intentions prêtées à Sam Altman, Elon Musk ou Dario Amodei.

Ghost in the Machine est diffusé sur la chaîne YouTube de PBS Documentaries et reste visible en version sous-titrée sur Mediapart jusqu'au 25 octobre 2026. ◆

IA et écriture : la mise en garde de Sarah Tadlaoui

16 octobre 2026 · 3 min · ia · ecriture · philosophie page seule ↗

Dans une tribune publiée par « Libération » le 14 octobre 2026, l'écrivaine et ancienne cheffe de produit de Google Sarah Tadlaoui s'interroge sur ce que l'IA fait à l'écriture. Son argument : une machine qui parle avec nos tournures et nos émotions pourrait finir par nous programmer en retour, d'où la nécessité de garder des espaces de réflexion et d'écriture sans elle. C'est une opinion, mais elle croise des travaux mesurés.

Qui écrit cette tribune

Sarah Tadlaoui, 39 ans, franco-marocaine et diplômée de l'université Columbia, a travaillé pour une mission humanitaire de l'ONU en Colombie avant de rejoindre l'unité d'intelligence artificielle de Google comme cheffe de produit, où elle a vu émerger l'IA générative, rapporte Afrik.com. Son premier roman, Croire au code (Éditions Héloïse d'Ormesson, 27 août 2026), suit une docteure en IA issue d'un milieu populaire, recrutée par une start-up puis broyée par la méritocratie de la tech. Le livre figure dans la première sélection du prix Médicis et parmi les douze titres en lice pour le Wepler-Fondation La Poste, selon Brut.

L'argument : la langue qui se retourne

Tadlaoui part d'une gêne qu'elle dit partager avec beaucoup, celle de l'écrivain devant la machine qui écrit. Ce qui la dérange, c'est la matière même de l'outil. La machine n'emprunte pas seulement nos mots, elle imite nos tournures et nos registres affectifs. En nous renvoyant une version lissée de notre propre langue, elle pourrait reformater à bas bruit notre manière de penser et de dire. Pour l'autrice, la parade est pratique plus que théorique. Elle consiste à préserver des moments d'écriture où l'outil n'entre pas.

Ce que disent les mesures

La crainte rejoint une observation documentée. Une étude de l'Institut Max Planck pour le développement humain, pas encore relue par les pairs, a isolé des mots que ChatGPT insère volontiers, puis suivi leur fréquence dans des vidéos et podcasts : après le lancement de l'outil, « delve » a progressé d'environ 48 % et « adept » de 51 % dans des contenus académiques parlés, détaille Scientific American. L'explication la plus simple reste que les orateurs rédigent d'abord leurs interventions avec l'IA, et le résultat porte sur des versions datées des modèles.

Côté écriture, le Journal du Net décrit une « écriture clonée » où les styles convergent vers un même lissage. Des chercheurs de l'université de New York avaient montré, à la conférence ICLR 2024, que l'assistance d'un grand modèle réduisait la diversité lexicale et argumentative des textes produits.

Une opinion, pas un verdict

La tribune reste un texte d'opinion. D'autres écrivains tiennent le discours inverse. Dans Libération toujours, Anton Beraber défend l'idée que la machine révèle ce que la littérature sait faire que la statistique ne sait pas. Tadlaoui ne nie pas l'outil, elle réclame un territoire à l'écart, dans la lignée des appels à continuer de penser par soi-même face à l'IA. Son pari rejoint la formule d'Ève Lambert, pour qui « mon écriture, c'est de la pensée » : écrire sans assistance, c'est garder la main sur ce qu'on pense.

Le jury du Médicis publie sa deuxième sélection le 15 octobre et proclame son lauréat le 2 novembre ; le prix Wepler sera décerné le 9 novembre 2026. ◆

arXiv plafonne les soumissions à deux par mois face aux papiers générés par IA

7 octobre 2026 · 2 min · ia · recherche · sciences page seule ↗

Depuis le 1er octobre 2026, arXiv limite chaque auteur à deux soumissions par mois et trois dépôts actifs à la fois. La plus ancienne archive de prépublications scientifiques, ouverte en 1991, ajoute ce plafond à une mesure prise un an plus tôt : depuis le 31 octobre 2025, les articles de synthèse et les textes de position déposés en informatique doivent justifier d'une acceptation en évaluation par les pairs. Les modérateurs bénévoles ne parviennent plus à trier les textes écrits avec des modèles de langage.

Un an, deux verrous

La première barrière vise une catégorie précise. Depuis octobre 2025, un article de synthèse ou un papier de position en informatique n'est accepté que s'il a déjà passé une évaluation par les pairs dans une revue ou une conférence. L'auteur doit fournir la preuve de cette validation au moment du dépôt, une relecture en atelier ne suffisant pas. arXiv justifie la règle par la qualité des textes reçus : « la majorité des articles de synthèse sont de faible qualité, sans discussion de fond », résume Steinn Sigurdsson, directeur scientifique de la plateforme, qui les compare à des bibliographies annotées. Le taux de rejet en informatique est passé d'environ 2 à 3 % jusqu'en 2023 à 10 % en 2024, selon la plateforme.

La seconde barrière est générale. Le plafond de deux soumissions mensuelles, entré en vigueur le 1er octobre 2026, s'applique à toutes les disciplines et s'accompagne d'une limite de trois dépôts actifs simultanés. arXiv dit recevoir des centaines d'articles de synthèse chaque mois, un volume que ses modérateurs ne peuvent plus examiner texte par texte. Les articles de recherche classiques ne tombent pas sous l'obligation de relecture : seuls les synthèses et les papiers d'opinion sont visés.

Le symptôme d'une édition saturée

Le resserrement prolonge un débat déjà ouvert. En septembre 2026, la plateforme SSRN avait retiré 257 prépublications de Nicholas Polson, professeur de statistique à Chicago, qui avait mis en ligne plus de 200 textes en neuf mois en assumant l'usage de l'IA (voir Le cas Polson divise les chercheurs). Même diagnostic du côté des revues : Holden Thorp, rédacteur en chef de Science, estime que l'IA rend l'édition scientifique « plus lente, de moins bonne qualité et plus chère » (notre article), les éditeurs devant réinjecter du travail humain là où l'automatisation était promise. Au-delà de l'informatique, toute l'édition scientifique affronte la même tension, celle d'évaluer par les pairs une production de texte devenue quasi gratuite (l'intégrité scientifique à l'épreuve).

arXiv prévient qu'elle étendra ces règles à d'autres domaines si le même afflux s'y manifeste. ◆

Rubrique 12 articles

Souveraineté

IA : 120 éditeurs allemands réclament à Francfort une transparence œuvre par œuvre

14 octobre 2026 · 6 min · ia · droit-auteur · edition · europe page seule ↗

Le 6 octobre 2026, à l'ouverture de la 78e Foire du livre de Francfort, le Börsenverein des Deutschen Buchhandels — fédération allemande des éditeurs et des libraires — a publié le « Frankfurter Appell ». Soutenu dès son lancement par 120 éditeurs, parmi lesquels Penguin Random House, Suhrkamp, Hanser, Rowohlt et Carlsen, le texte demande à la Commission européenne, au Parlement européen et au gouvernement allemand trois choses : une transparence œuvre par œuvre sur les données qui entraînent les intelligences artificielles, un marché de licences et des moyens renforcés pour faire respecter le droit d'auteur.

Un appel lancé en ouverture de la Foire

L'appel a été rendu public pendant la conférence de presse d'ouverture de la Foire, qui s'est tenue du 7 au 11 octobre. Selon ActuaLitté, le communiqué du Börsenverein mentionnait 120 maisons déjà engagées, dont Penguin Random House Verlagsgruppe, Holtzbrinck Buchverlage, Bonnier Media Deutschland, Diogenes et Bastei Lübbe. La Fédération des éditeurs européens et l'International Publishers Association figuraient aussi parmi les soutiens affichés.

Le ton est celui d'une filière qui estime n'avoir pas avancé. Son président, Sebastian Guggolz, juge le secteur « pratiquement au même point qu'il y a un an » sur la rémunération des œuvres servant à entraîner les modèles, rapporte Livres Hebdo. Il réclame une intervention politique « rapide et déterminée » et, surtout, des règles qui s'appliquent sans qu'un ayant droit soit d'abord contraint de porter plainte. Le Börsenverein a prolongé le propos par une table ronde, le 8 octobre, réunissant la présidente de la commission Culture et Éducation du Parlement européen et un représentant du ministère fédéral de la Justice.

Trois demandes adressées à Bruxelles et à Berlin

La première revendication porte sur la granularité de la transparence. Les éditeurs veulent que les fournisseurs d'IA divulguent les « données d'entraînement concrètes pour chaque œuvre », et non la seule mention qu'un modèle a été nourri de livres en général. Aujourd'hui, un éditeur qui soupçonne l'utilisation de son catalogue doit chercher lui-même des indices, puis engager une procédure contre des entreprises bien plus puissantes que lui, une voie que la plupart des maisons européennes n'ont pas les moyens d'emprunter.

La deuxième demande vise la mise en place d'un marché de licences, fondé sur des modèles de revenus équitables, pour que l'exploitation des catalogues passe par des accords et une rémunération. L'idée prolonge des initiatives déjà lancées par la profession, à l'image de la place de marché Bookpact.ai montée par les éditeurs néerlandais, qui laisse l'éditeur décider titre par titre des usages autorisés et de leur prix.

La troisième concerne l'application du droit. Le Börsenverein réclame des moyens renforcés pour faire respecter le droit d'auteur européen et une clarification de la responsabilité des fournisseurs d'IA, notamment face aux réserves de droits (les opt-out) souvent ignorées. L'enjeu, répété par Guggolz, est de sortir d'une logique où la charge de la preuve et du contentieux repose entièrement sur le créateur.

Ce que l'AI Act prévoit déjà, et ses limites

L'appel intervient alors qu'un cadre existe déjà, mais ne va pas aussi loin que le réclament les éditeurs. L'article 53 de l'AI Act, applicable aux modèles à usage général depuis le 2 août 2025, impose à leurs fournisseurs de publier un résumé des données d'entraînement et de mettre en place une politique de respect du droit d'auteur européen. Mais le modèle de résumé diffusé par la Commission privilégie, selon l'analyse du cabinet Bird & Bird, des informations agrégées et un récit général : liste des grands jeux de données publics et des sources sous licence, sans inventaire détaillé titre par titre. Le considérant 108 précise d'ailleurs que le Bureau européen de l'IA vérifie ces obligations sans évaluer les données œuvre par œuvre. La demande de Francfort se situe donc en deçà de ce que le dispositif actuel accepte de contrôler.

S'y ajoute le Code de bonnes pratiques pour les modèles à usage général, publié en juillet 2025. Il reste volontaire ; ses signataires bénéficient d'une présomption de conformité, quand un fournisseur qui n'y adhère pas doit justifier ses mesures dès le départ, détaille le cabinet Clifford Chance. Son chapitre consacré au droit d'auteur reprend l'obligation d'identifier et de respecter les réserves de droits qui empêchent l'usage d'une œuvre pour la fouille de textes et de données. Cette fouille repose sur l'exception de la directive de 2019 sur le marché unique numérique, dont l'article 4 autorise l'utilisation des œuvres licitement accessibles, sauf réserve expresse de leur titulaire. Le débat européen sur l'efficacité réelle de cet opt-out n'est pas clos, comme l'ont montré les travaux parlementaires sur le droit d'auteur et l'IA.

Un précédent judiciaire allemand

Le calendrier de l'appel doit beaucoup à une décision rendue en Allemagne. Le 11 novembre 2025, le tribunal régional de Munich a condamné OpenAI dans un litige l'opposant à la société de gestion GEMA, à propos de l'entraînement de GPT-4 et GPT-4o sur les paroles de neuf chansons allemandes, dont « Atemlos » et « Männer ». Le tribunal a estimé que les paroles étaient stockées dans le modèle sous une forme permettant leur restitution fidèle, et que cette mémorisation valait reproduction, analyse le Verfassungsblog. Il a écarté l'application de l'exception de fouille de textes et de données : celle-ci peut couvrir l'entraînement, mais pas lorsqu'il aboutit à mémoriser les œuvres protégées. OpenAI a été condamnée à cesser ces reproductions et déclarée redevable de dommages-intérêts. La décision est de première instance.

Pour les éditeurs, l'affaire illustre à la fois une possibilité et une impasse. Elle montre qu'un juge européen peut sanctionner l'usage non autorisé d'œuvres, mais elle rappelle aussi que la victoire a nécessité les moyens d'une société de gestion collective puissante. Deux maisons, Penguin Random House et Carlsen, ont engagé des procédures pour des plagiats qu'elles jugent manifestes, précise Livres Hebdo, mais la fédération souligne que la majorité des éditeurs européens n'en ont pas la capacité. C'est le sens de la formule retenue pour l'un des débats de la Foire : « D'abord la plainte, ensuite la régulation ». La fracture entre ayants droit démunis et acteurs capables d'agir recoupe celle déjà décrite par le rapport parlementaire sur le droit d'auteur et l'IA.

Une bataille déjà engagée ailleurs

L'appel de Francfort rejoint un mouvement européen plus ancien. En 2023, un texte comparable, lancé depuis la même Foire par plusieurs organisations du livre, demandait déjà que les ayants droit puissent savoir si leurs créations avaient servi à entraîner des modèles. Depuis, les lignes ont bougé du côté des accords commerciaux : Google a conclu des contrats de licence avec des éditeurs pour alimenter ses aperçus génératifs, au prix de vives contestations sur le partage de la valeur. Les éditeurs allemands cherchent à inscrire ces pratiques dans un cadre légal plutôt que de les laisser au gré de négociations bilatérales.

Aucune proposition législative ne répond directement au Frankfurter Appell. Le résumé des données d'entraînement prévu par l'article 53 demeure le seul instrument contraignant de transparence à l'échelle de l'Union, et son modèle n'exige pas l'inventaire œuvre par œuvre que réclament les 120 éditeurs. ◆

Klaba (OVHcloud) : « trop risqué de ne pas investir » dans l'IA

3 octobre 2026 · 2 min · ia · souverainete-numerique · ovhcloud · datacenters page seule ↗

Auditionné le 1er octobre par la commission des affaires économiques de l'Assemblée nationale, Octave Klaba a résumé sa stratégie d'une phrase : pour OVHcloud, « c'est trop risqué de ne pas investir dans l'intelligence artificielle ». Le fondateur du groupe roubaisien a détaillé devant les députés sa lecture de la dépendance européenne, du coût des cartes graphiques et de la course aux datacenters.

Une dépendance que Klaba chiffre

Le point de départ est un constat de fragilité. « Les technologies sont principalement américaines ou chinoises », a posé Klaba, qui compte peu d'acteurs européens investissant dans l'IA. Il avance un chiffre pour mesurer l'écart. Seulement 3 % du volume des puces de RAM sont achetés en Europe, le reste de l'innovation se concentrant aux États-Unis et en Asie.

Le recours massif aux modèles open source chinois ne le rassure pas. On ignore, dit-il, « ce qui va se passer demain, ni la stratégie » des entreprises qui les publient : rien ne garantit que cette mise à disposition se poursuive. D'où sa conclusion, que ne pas investir expose à un risque plus grand que d'investir. OVHcloud mise sur des acquisitions pour étoffer ses équipes et sur l'entraînement de ses propres modèles, autour de trois chantiers : la cybersécurité, le développement logiciel et l'agentique.

Le prix de l'infrastructure

Klaba a aussi décrit aux députés la difficulté industrielle. L'accès aux processeurs graphiques de Nvidia reste le premier obstacle, et le matériel vieillit vite. Les cartes H100, lancées il y a trois ans, ont « perdu pratiquement 80 % de la valeur ». Les datacenters d'IA eux-mêmes doivent suivre le rythme des GPU. « Dans 18 ou 12 mois, vous devrez rétrofiter » les systèmes de refroidissement et les chaînes électriques, a-t-il prévenu, décrivant un équipement qui se périme au fil des générations de puces.

Cette course coûteuse se double, selon lui, d'une bonne nouvelle pour les Européens : la barrière financière baisse. Un projet de modèle qui demandait un milliard d'euros il y a quatre ans se monte aujourd'hui pour 150 à 200 millions, estimait-il fin septembre à Luxembourg. OVHcloud a intégré début 2026 la société de chiffrement Seald puis la start-up parisienne Dragon LLM, ex-Lingua Custodia, lauréate du Grand AI Challenge de la Commission européenne. Le pré-entraînement d'un premier modèle a été mené sur Jupiter, le supercalculateur EuroHPC installé en Allemagne.

Ces chantiers relèvent du plan stratégique « Step Ahead » que le groupe déroule sur 2026-2030. OVHcloud revendique 1,2 milliard d'euros de chiffre d'affaires, 46 datacenters et 250 mégawatts de capacité, loin derrière les hyperscalers américains dont Klaba veut réduire la part dans les usages européens. Le fondateur a repris la direction générale du groupe en octobre 2025. ◆

Mistral met un modèle chinois par défaut dans son assistant de code

27 septembre 2026 · 6 min · ia · souverainete page seule ↗

Le laboratoire français Mistral AI a fait de GLM 5.3, un modèle édité par la société chinoise Z.ai (ex-Zhipu), l'option par défaut de la version Web de Vibe Code, son assistant de génération de code. L'annonce du 21 septembre 2026 étend un choix déjà amorcé l'été précédent, et la décision est moins chère pour Mistral que ses propres modèles. Elle a rouvert un débat sur ce que devient une entreprise présentée comme le champion européen de l'IA quand elle sert par défaut une technologie venue de Chine.

Ce que Mistral a changé

Jusqu'ici, les requêtes de Vibe Code étaient traitées par les modèles maison de Mistral, Medium 3.5 et Large 3. Depuis le 21 septembre, l'application Web bascule par défaut sur GLM 5.3, et Mistral prévoit d'étendre ce réglage à son extension VS Code, à son client en ligne de commande et au mode Work de la version Web (Next).

Vibe Code est l'agent de codage de Mistral, disponible dans le terminal, dans l'éditeur (extensions VS Code, JetBrains, Zed) et sur le Web. Il descend de Mistral Code, lancé en juin 2025, et se positionne face aux assistants de génération de code américains. La page produit met en avant plusieurs modèles maison — Devstral 2, Codestral, Codestral Embed — mais c'est désormais un modèle tiers qui prend la main sur le réglage par défaut du Web (Mistral).

Le geste n'est pas isolé. Mistral proposait déjà GLM 5.2 à ses clients depuis l'été 2026, d'abord via son API, sans en faire le choix par défaut. GLM 5.3 est arrivé en « public preview » sur la plateforme le 15 septembre. Le passage par défaut, six jours plus tard, transforme une option pour développeurs avertis en réglage que rencontre tout utilisateur du Web.

Un modèle chinois, et moins cher que ceux de la maison

GLM 5.3 est décrit par Mistral comme « un modèle de texte tiers à poids ouverts de Z.ai, hébergé par Mistral ». Il affiche une fenêtre de contexte d'un million de tokens et une sortie maximale de 128 000 tokens, ce qui le destine, selon la documentation, au « codage à contexte long et aux workflows agentiques » (Mistral Docs).

L'argument économique pèse dans la bascule. Sur la plateforme de Mistral, GLM 5.3 est facturé 1,4 dollar par million de tokens en entrée, 0,14 dollar pour l'écriture en cache et 4,4 dollars en sortie. Les mêmes postes coûtent respectivement 1,5, 0,15 et surtout 7,5 dollars pour Mistral Medium 3.5. L'écart tient donc à la sortie, presque deux fois moins chère avec le modèle chinois qu'avec le modèle maison (Next). Servir GLM 5.3 par défaut réduit d'autant le coût des requêtes incluses dans les abonnements.

Z.ai est la marque internationale de l'entreprise chinoise historiquement connue sous le nom de Zhipu AI. Elle figure sur une liste noire américaine depuis janvier 2025, au titre de contributions jugées utiles à l'armée chinoise, la même mécanique de contrôle des exportations que Washington a activée contre d'autres acteurs de l'IA. Les analystes relèvent régulièrement la contradiction, celle d'une entreprise européenne qui réduirait sa dépendance aux modèles américains en s'appuyant sur une technologie chinoise que les États-Unis cherchent à contenir (aivancity).

La souveraineté par l'infrastructure, ou par les modèles ?

Mistral défend une distinction : la souveraineté ne dépendrait pas de l'origine nationale du modèle, mais du contrôle de son déploiement et de l'infrastructure qui l'exécute. L'entreprise héberge GLM sur ses propres centres de données, en France et en Suède, et met en avant ses engagements de calcul, avec un objectif d'un gigawatt de puissance dédiée à l'IA d'ici 2030.

Concrètement, un client européen peut interroger un modèle entraîné en Chine sans que ses prompts quittent l'infrastructure de Mistral pour l'API chinoise de Z.ai (The Pingouin). Mistral transforme ainsi ses centres de données en couche d'inférence multi-modèles : chaque utilisateur attiré par GLM devient un utilisateur de son infrastructure, ce qui lui permet de monétiser son calcul indépendamment de ses propres modèles.

Les analyses plus critiques rappellent les limites de ce raisonnement. Héberger un modèle localement ne réécrit pas ce qu'il a appris. Les choix de données d'entraînement et d'alignement restent ceux de l'éditeur. La documentation de Mistral distingue aussi l'inférence régionale de l'absence de conservation des données, ce qui oblige les entreprises soucieuses de conformité à vérifier séparément les conditions de rétention. La résidence des données en Europe n'emporte donc pas automatiquement l'autonomie technologique.

Le débat n'est pas neuf en France. En juin 2026, la coupure brutale par l'américain Anthropic de l'accès à ses modèles pour les ressortissants étrangers, sur ordre de Washington, avait réuni la classe politique française autour du mot « souveraineté », Jordan Bardella exhortant alors Paris à « accélérer dans le soutien » à Mistral. Trois mois plus tard, le champion désigné choisit de servir par défaut un modèle chinois.

Le procès en « renoncement »

C'est sur ce point que la décision fait réagir. Pour une partie des commentateurs, dont de nombreuses voix sur les réseaux sociaux, mettre GLM 5.3 par défaut revient à admettre à demi-mot que Mistral ne propose plus le meilleur modèle de code du marché et renonce à l'ambition de rivaliser sur les modèles de frontière (Next).

Le reproche va parfois plus loin. Mistral deviendrait un simple intégrateur, un « revendeur d'inférence » fonctionnant comme une société de services numériques, davantage que le laboratoire de pointe présenté par les médias et les politiques. La comparaison de prix nourrit cette lecture. Si le modèle chinois est meilleur marché et jugé au moins aussi bon pour le code, servir Medium 3.5 par défaut coûterait plus cher pour un résultat qui n'est pas supérieur.

D'autres retournent l'argument. Pour eux, il est plus honnête d'offrir aux développeurs le modèle qui fonctionne le mieux que de leur imposer un modèle maison par principe, et une place de couche d'inférence européenne pour les meilleurs modèles ouverts, y compris chinois, reste une position stratégique défendable (Frandroid, via Shango). Ils soulignent que Mistral continue de développer ses propres modèles : Large 3, publié en décembre 2025, revendiquait 675 milliards de paramètres.

La discussion tourne vite au politique parce qu'elle touche à un récit national. La France s'est dotée d'un champion de l'IA, et ce champion préfère servir la technologie d'un autre. Rien dans l'annonce n'indique pourtant que Mistral abandonne ses modèles : l'entreprise change le réglage par défaut d'un produit, pas sa feuille de route. GLM 5.3 est en « public preview » sur la plateforme depuis le 15 septembre 2026, et Mistral n'a pas publié de calendrier pour l'étendre par défaut au-delà de la version Web de Vibe Code. ◆

Rubrique 24 articles

Le reste du fil

L'Artefact AI Film Festival rouvre ses candidatures pour une troisième édition

24 octobre 2026 · 2 min · ia · cinema page seule ↗

L'Artefact AI Film Festival, concours de courts-métrages réalisés avec l'intelligence artificielle générative, a ouvert les candidatures de sa troisième édition le 2 septembre 2026. Organisé par le cabinet de conseil en données et IA Artefact et le groupe de cinéma mk2, il confie cette année la présidence du jury à Olivier Nakache et Éric Tolédano (« Intouchables », « Hors normes »), annoncés en juin 2026.

Un cahier des charges qui impose la machine

Le règlement est strict. Les films ne dépassent pas 314 secondes et doivent recourir à au moins un outil d'IA générative à chacune des phases de fabrication (pré-production, production, post-production). Chaque candidat joint un journal de production, une « recette » qui liste les logiciels employés et une partie des prompts. L'organisateur dit s'en servir pour vérifier le respect des règles et de la propriété intellectuelle.

Le concours distribue un Grand Prix de 10 000 euros, un prix du jury et un prix du public dotés de 1 000 euros chacun, et un prix « Best Use of AI » également de 1 000 euros. Les candidatures courent jusqu'au 2 décembre 2026, le vote en ligne du public du 9 décembre au 13 janvier 2027, pour une cérémonie prévue en février 2027.

De Jeunet au duo d'« Intouchables »

Lancé en 2024 avec un jury présidé par Jean-Pierre Jeunet et le thème « Reality(ies) », le festival en est à sa troisième saison. La deuxième, présidée par Cédric Klapisch, a réuni 265 candidatures dont 223 films venus de 52 pays ; son Grand Prix est allé en février 2026 à « The Cinema that Never Was » de Mark Wachholz. Artefact, cabinet qui revendique 2 500 experts, et mk2, qui compte environ 7 millions de spectateurs par an dans ses salles, présentent l'opération comme un moyen d'abaisser les barrières d'entrée de la création audiovisuelle. Leurs dirigeants répètent vouloir « stimuler, et non remplacer » les artistes.

L'argument ne clôt pas la controverse. L'IA générative dans le cinéma bute sur les droits d'auteur et le consentement des interprètes. L'Académie des Oscars a tranché en mai 2026 : seuls les rôles tenus par des humains, avec leur accord, et les scénarios écrits par des humains restent éligibles à ses récompenses, après avoir posé en 2025 que l'usage d'outils d'IA « ne favorise ni ne nuit » aux chances d'un film. En France, la polémique sur l'emploi a éclaté au festival d'Annecy en juin 2026, tandis que Google prenait une participation dans le studio A24 pour développer des outils destinés aux cinéastes. Un concours qui rend la machine obligatoire à chaque étape prend le chemin inverse de l'académie hollywoodienne.

Les lauréats de la troisième édition seront connus en février 2027. ◆

Champignons : les applis d'identification par IA inquiètent les mycologues

24 octobre 2026 · 5 min · ia · sante · champignons page seule ↗

Plus de 700 intoxications aux champignons ont été recensées en France depuis début septembre, selon les autorités sanitaires. La première cause reste l'erreur d'identification au moment de la cueillette. Parmi les pièges qui montent, les sociétés de mycologie et les centres antipoison visent un outil devenu réflexe en forêt, l'application qui prétend reconnaître une espèce à partir d'une simple photo.

Près de 700 cas depuis la rentrée

Le compteur a grimpé vite cet automne. Les centres antipoison ont reçu près de 500 signalements d'intoxication en septembre, et plus de 200 autres depuis le 1er octobre, soit un total supérieur à 700 depuis la rentrée, selon le bilan diffusé le 20 octobre par les autorités sanitaires et relayé par l'AFP. Le rythme n'a pas ralenti, et le pic de la saison se situe habituellement en octobre.

La dernière saison complète donne la mesure du danger. En 2025, les centres antipoison ont enregistré environ 1 500 intoxications alimentaires liées aux champignons, dont un pic de plus de 600 cas dès septembre. La plupart se limitaient à des troubles digestifs, mais 3 % étaient graves, avec un décès et trois greffes du foie. L'Anses place en tête des causes la confusion entre une espèce comestible et une espèce toxique, devant la mauvaise conservation, les spécimens abîmés et la cuisson insuffisante. Le risque ne se limite pas aux cueilleurs : une partie des cas de 2025 concernait des champignons achetés dans le commerce ou servis au restaurant.

Comment fonctionnent ces applications

Champignouf, Champignon Pro, IK-Champi, Picture Mushroom : les applications les plus téléchargées en France reposent toutes sur le même principe. L'utilisateur photographie sa trouvaille, un modèle de reconnaissance d'images entraîné sur des milliers de clichés compare les formes et les couleurs, puis renvoie une ou plusieurs espèces « probables » assorties d'un pourcentage de confiance. Le résultat tombe en quelques secondes, gratuitement pour la plupart des fonctions de base.

Le problème tient à ce que l'image ne montre jamais. Deux champignons peuvent se ressembler trait pour trait sur une photo et se distinguer par l'odeur, la texture de la chair, la couleur à la coupe ou le type de sol sous les arbres. Un modèle visuel ne perçoit aucun de ces critères, et il répond toujours quelque chose, même quand aucune espèce de sa base ne correspond vraiment. L'Anses résume sa position en une consigne, ces applications peuvent aider à découvrir des espèces, pas à décider ce qui finit dans l'assiette.

« Elles se trompent à plus de 50 % »

Le chiffre le plus parlant vient du centre antipoison de Paris. Après l'intoxication sévère d'une famille de trois personnes qui s'étaient fiées à une application, ses médecins ont lancé un travail d'évaluation : des photos envoyées par des particuliers inquiets ont été passées dans les applications du marché, puis comparées à l'identification réelle. Le toxicologue Jérôme Langrand en tire un verdict net, ces applications se trompent à plus de 50 % sur l'espèce. Son conseil est de s'abstenir de manger tout champignon identifié par ce seul moyen.

L'Anses relève depuis plusieurs saisons des cas d'intoxication où la confusion a été favorisée par une identification erronée fournie par une application. L'agence reconnaît que le phénomène reste trop récent pour en chiffrer précisément l'ampleur, quelques dizaines de cueilleurs ayant utilisé ces outils parmi les victimes des dernières saisons recensées. La consigne officielle n'a pas varié : ne consommer aucun champignon dont l'identification repose sur une application de smartphone, en raison du risque élevé d'erreur.

La prudence rejoint une inquiétude déjà documentée pour les conseils de santé livrés par des IA conversationnelles, dont les réponses assurées masquent une marge d'erreur invisible pour l'utilisateur. Dans le cas des champignons, cette erreur se paie en jours d'hôpital.

Les confusions qui envoient à l'hôpital

La toxicité ne se devine pas à l'œil, et certaines ressemblances sont redoutables. L'amanite phalloïde, responsable de la plupart des intoxications mortelles, peut être prise pour une coulemelle et provoquer une atteinte du foie parfois fatale. La confusion la plus fréquente reste plus bénigne mais très répandue. En 2024, de nombreux cueilleurs ont ramassé des clitocybes de l'olivier en les prenant pour des girolles ou des chanterelles, ce qui déclenche de violents troubles digestifs et une déshydratation, rappelle L'InfoDurable.

Les chiffres des années précédentes confirment la régularité du risque. Entre le 1er juillet et le 31 décembre 2024, 1 363 personnes ayant consommé des champignons ont appelé un centre antipoison, trois sont mortes et trois ont développé une insuffisance rénale chronique. Une application qui signale « girolle » avec 80 % de confiance ne corrige aucune de ces erreurs, elle les valide.

Les gestes qui protègent vraiment

Les spécialistes ne demandent pas de renoncer à la cueillette, mais de reprendre les réflexes d'avant le smartphone. Le premier reste de ne ramasser que les espèces que l'on connaît parfaitement, en prélevant le champignon entier, pied compris, car des détails de la base servent à l'identification.

Vient ensuite le contrôle humain, le seul fiable. En cas de doute, il faut faire vérifier l'intégralité de la récolte par un pharmacien ou par une association de mycologie avant toute consommation, y compris pour des champignons reçus en cadeau. Les sociétés mycologiques locales tiennent des permanences d'automne et des sorties encadrées, et certaines officines expérimentent une aide à l'identification en lien avec des experts de la Société mycologique de France. Le pharmacien n'est toutefois pas mycologue de formation, et le recours à un spécialiste s'impose au moindre doute persistant.

Quelques règles complètent la vérification. Les champignons sauvages se cuisent au moins vingt minutes avant d'être mangés, à l'exception de rares espèces comme les champignons de Paris et les truffes, et ne se consomment jamais crus. Ils ne doivent pas être donnés à de jeunes enfants. L'Anses recommande aussi de photographier sa cueillette avant de la cuisiner, non pour la faire valider par une application, mais pour aider les médecins à identifier rapidement l'espèce en cas de symptômes.

En cas de nausées, de vomissements, de diarrhées ou de troubles neurologiques après un repas de champignons, les autorités invitent à contacter sans délai un centre antipoison ou le 15. Le pic de la saison étant attendu en octobre, les signalements devraient continuer d'affluer dans les semaines qui viennent. ◆

Alain Sachs met l'IA à l'épreuve sur scène

12 octobre 2026 · 2 min · theatre · ia · litterature page seule ↗

Le metteur en scène Alain Sachs joue « Un pur chef-d'œuvre » au Théâtre de Passy, à Paris, jusqu'au 2 janvier 2027, et le présente comme « la première intégralement écrite par l'intelligence artificielle ». Il laisse le doute planer sur cette affirmation, au moment où les milieux littéraires sont secoués par l'affaire Thélyson Orélien.

Une comédie qui « prétend » avoir été écrite par la machine

Le programme du Théâtre de Passy annonce la pièce comme « la première comédie qui prétend avoir été intégralement écrite par l'intelligence artificielle ». Sachs signe le texte, la mise en scène et joue sur le plateau. Au lever de rideau, il dévoile les consignes qu'il aurait données à la machine : une pièce drôle, cinq rebondissements, tous les codes du boulevard. Six personnages, convoqués par un bienfaiteur mystérieux, s'enfoncent ensuite dans un labyrinthe loufoque qui oscille entre menace et vaste blague. La distribution réunit Isabelle Tanakil, Jacques Fontanel, Léa Py, Emilien Fabrizio et Stéphane Titeca. Les places vont de 26,50 à 46,50 euros, selon la billetterie.

Le dispositif tient dans l'ambiguïté que Sachs refuse de lever. Il dit croire que l'IA ne sera jamais capable de produire une œuvre dramatique digne de ce nom, tout en admettant qu'« on n'est pas à l'abri ». La pièce finit en déclaration d'amour au théâtre, aux auteurs, aux comédiens et au public, livrée, précise-t-il, par « une intelligence 100 % humaine ». Sachs a produit le spectacle lui-même et redoute que les programmateurs, prudents sous la contrainte budgétaire, boudent cet objet non identifié pour une tournée.

Le théâtre répond à la polémique du livre

La provocation tombe pendant l'affaire qui agite l'édition. Le romancier Thélyson Orélien, lauréat du Prix du Roman Fnac 2026 pour « C'était ça ou mourir », a été accusé le 21 septembre, par le compte anonyme « Balance ton Claude », d'avoir écrit son livre avec une IA, sur la foi du détecteur Pangram. L'auteur dément et ses éditeurs le soutiennent. L'Académie Goncourt a retiré le roman de sa sélection le 25 septembre, invoquant l'intégrité du prix, et son éditeur canadien Boréal a suspendu la promotion du titre, écoulé à près de 65 000 exemplaires en six semaines. Orélien fait aussi l'objet d'accusations de plagiat sur des textes de 2010 et 2014. Les accusations d'IA reposent sur un détecteur, dont les résultats ne constituent pas à eux seuls une preuve.

Là où le livre se défend d'avoir recouru à la machine, le théâtre revendique l'inverse pour mieux poser la question. La même inquiétude traverse d'autres arts : au festival d'Annecy, l'IA générative est devenue un sujet de crispation sur l'emploi. « Un pur chef-d'œuvre » reste à l'affiche au Théâtre de Passy jusqu'au 2 janvier 2027. ◆